笔者用LLM翻译的《Design and Analysis of Experiments》第10版已上线(链接),可供参考。
统计学的核心任务:收集并分析数据,并解决特定问题(推断/预测等)
- 其中数据分析方法包括数理统计/机器学习/深度学习方法等,而收集数据的方法则包括抽样调查与试验设计(以及人工合成数据……)
- 抽样调查与试验设计的主要区别如下:
抽样调查(“看谁”) 试验设计(“对谁做什么”) 从总体中抽取样本 处理试验单位 自变量的值自然出现 需主动设置自变量值 研究总体特征、分布与关联 研究因素影响与因果关系 - 试验设计的核心目的:节省试验次数,减少随机误差影响,高效抓住事物规律。试验设计是统计学最早与使用最广泛的分支之一,包括方差分析、正交设计、析因设计等。
引言
一个典型的例子:研究两种淬火工艺——油淬与盐水淬——对合金硬度的影响。由此我们可以得到:
- 研究目标:测试样品在不同工艺下淬火后的平均硬度,再作比较
- 需要解决的问题:
- 是否有其他影响硬度的因子?【考虑控制变量】
- 样品数量应该达到是多少?对样品的淬火方案应该如何分配?
- 按什么次序收集数据?如何进行数据分析?
- 两种工艺得到的平均观测硬度差别应达到多大才能认定为有显著差异?
试验设计的策略
- 目标:得到因果关系(从观察与试验中得到)
- 构建经验模型(与机理模型不同,后者是先有结论再用实验验证)
- 经验模型的一般形式如图:
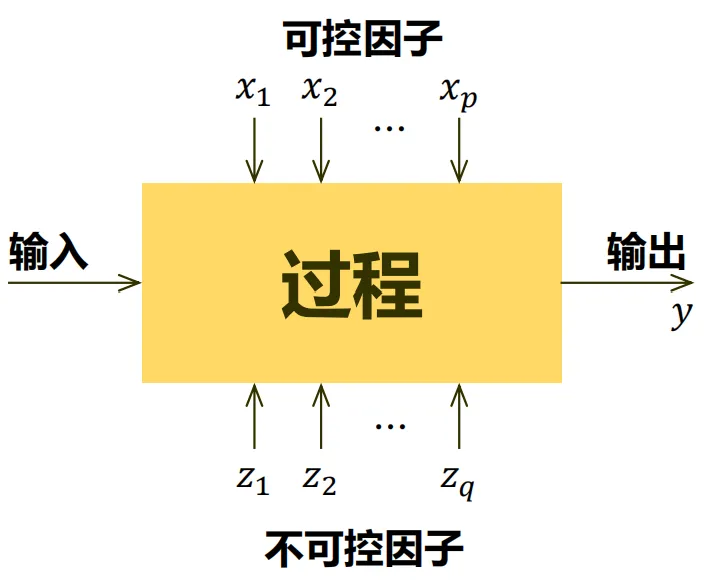
其中输出可以为一个或多个可观测的响应变量,同时应当尽量减小不可控因子的影响 - 经验模型的研究目的:
- 确定哪些变量对的影响最大;
- 确定将有影响的变量设为何值时可以使得接近期望水平;
- 确定将有影响的变量设为何值时可以使得波动性较小;
- 将有影响的变量设为何值时可以使得不可控因子的影响最小。
- 经验模型的一般形式如图:
- 常见的试验设计策略如下:
- 最佳猜测法
自主选择任意认为可能有关系的因子组合,每次改变一两个因子水平后重复试验- 优点:效果通常较好
- 缺点:若最初猜测组合的结果不如预期,则往往需要做多次组合,效率较低(难以直接找到最优组合)
- 一次一因子法
对每个因子选择初始值,每次只改变一个因子,保持其他因子不变- 优点:解释更直观(完全遵循控制变量)
- 缺点:没有考虑因子间的交互作用(对结果的共同影响)
- 析因实验法
改变多个因子,考虑所有可能的因子取值组合(共次试验)
优点:可以充分高效地利用数据(同时研究单因子效应和交互作用)【可考虑与假设检验结合】
缺点:试验次数较多,成本较高 - 分式析因实验法
只对所有可能组合的一个子集作试验(尽量选择因子取值有明显差别的组合)【可节约成本】
实际应用
-
因子筛选(screening)实验(也称为因子表征实验)
- 实验目的:估计因子效应的大小与方向,以及因子间是否存在交互作用
- 一般会采用分式析因实验法
-
过程最优化
- 主要目的:确定能够使结果达到最优的因子的范围
- 实际上,存在相同响应变量的因子取值构成的等值线,它可以看作一种响应曲面(response surface)的投影。【实际难以直接绘制】
- 过程最优化的本质就是通过改变可控因子,不断迭代寻找最优响应曲面的过程。其试验设计方法一般会采用中心复合设计。
试验设计基本原则
基本原理
-
随机化
是统计分析方法的基石,具体表现为:- 实验材料的分配和实验中各次实验进行的顺序都是随机确定的;
- 统计方法要求观测值(或误差)是独立分布的随机变量,随机化通常能使这一假定有效;
把实验进行适当的随机化还有助于“平均掉”可能出现的外来因子的效应。
-
重复(试验)
即对每个因子水平组合进行独立重复实验,由此可以得到试验误差的估计,并使均值估计更准确(减小方差)。- 重复试验与重复测量之间的差别:重复实验既反映实验间的变异又反映实验内的变异,重复测量则只反映一次实验内的变异。
-
区组化
用于减少或消除干扰因子带来的影响,并提高试验精度。【这里的干扰因子是指可能影响响应变量的值,但研究不直接感兴趣的因子】
试验设计的准则
试验设计的准则(标准)一般分为以下七步(其中前三步都属于试验前的计划):
-
识别并陈述问题
关键是明确试验的具体目标以及需要解决的问题(与目标紧密相关)- 试验的基本类型包括:因子筛选或表征、最优化试验、验证试验、探索性试验与稳健性试验。
- 推荐的做法是按照序贯方法设计试验(将大的综合性试验按目标分解为小试验)
-
选择响应变量
一般会考虑将被测特性的平均值或标准差(或同时取二者)作为响应变量。另一方面,测量系统的误差也是一个重要考量,它决定了响应变量的测量次数。 -
选择因子、水平与范围
首先我们对可能有影响的因子进行分类:-
潜在设计因子
- 设计因子:在实验中被选择用来研究的因子
- 保持恒定因子:可能对响应有一些影响的变量,但就实验目的而言,实验者对这些因子并不感兴趣,它们在实验中保持在一个特定的水平
- 允许变化因子:不对其控制,任其自然变化,可通过随机化来抵消或降低其影响
通常假定保持恒定的因子和允许变化的因子的效应都相对较小。
-
干扰因子
- 可控因子:其水平可被实验者设置,可以用区组来处理
- 不可控因子:可以测量,且可采用协方差分析来补偿其效应
- 噪声因子:在过程中自然变化且不可控制,但可以用随机化进行处理
上述因子的归类可以通过因果(鱼骨)图进行确定。
-
-
选择试验设计
包括考虑样本量(重复次数)、为试验安排合适的运行顺序,以及确定是否涉及区组化或其他随机化限制。除此之外,设计的选择还涉及考虑和选定一个初步的经验模型来描述结果。 -
实施试验
-
统计分析数据
-
结论与建议
如果对实验数据不满意,可以进行后续实验。随着试验计划的推进,我们常常剔除一些输入变量、加入另一些变量、改变某些因子的探索区域,或者增加新的响应变量等。
试验设计简史
- 1920s(农业时期):Fisher提出试验设计基本原理,在试验结果分析中引入统计方法;
- 1930s(工业时期):以Box为代表人物,将试验设计融入工业试验中;
- 1970s(第三时期):以田口玄一为代表人物,引入多种概念,完善了试验设计理论;
- 1980s至今(后田口时期):对田口方法的质疑与改进。
简单比较试验
本章大部分概念已经在数理统计Cheat Sheet中有所涉及,故这里仅作简单提及,具体细节作略。