笔者用LLM翻译的《Design and Analysis of Experiments》第10版已上线(链接),可供参考。
统计学的核心任务:收集并分析数据,并解决特定问题(推断/预测等)
- 其中数据分析方法包括数理统计/机器学习/深度学习方法等,而收集数据的方法则包括抽样调查与试验设计(以及人工合成数据……)
- 抽样调查与试验设计的主要区别如下:
| 抽样调查(“看谁”) |
试验设计(“对谁做什么”) |
| 从总体中抽取样本 |
处理试验单位 |
| 自变量X的值自然出现 |
需主动设置自变量值x |
| 研究总体特征、分布与关联 |
研究因素影响与因果关系 |
- 试验设计的核心目的:节省试验次数,减少随机误差影响,高效抓住事物规律。试验设计是统计学最早与使用最广泛的分支之一,包括方差分析、正交设计、析因设计等。
引言
一个典型的例子:研究两种淬火工艺——油淬与盐水淬——对合金硬度的影响。由此我们可以得到:
- 研究目标:测试样品在不同工艺下淬火后的平均硬度,再作比较
- 需要解决的问题:
- 是否有其他影响硬度的因子?【考虑控制变量】
- 样品数量应该达到是多少?对样品的淬火方案应该如何分配?
- 按什么次序收集数据?如何进行数据分析?
- 两种工艺得到的平均观测硬度差别应达到多大才能认定为有显著差异?
试验设计的策略
- 目标:得到因果关系(从观察与试验中得到)
- 构建经验模型(与机理模型不同,后者是先有结论再用实验验证)
- 经验模型的一般形式如图:
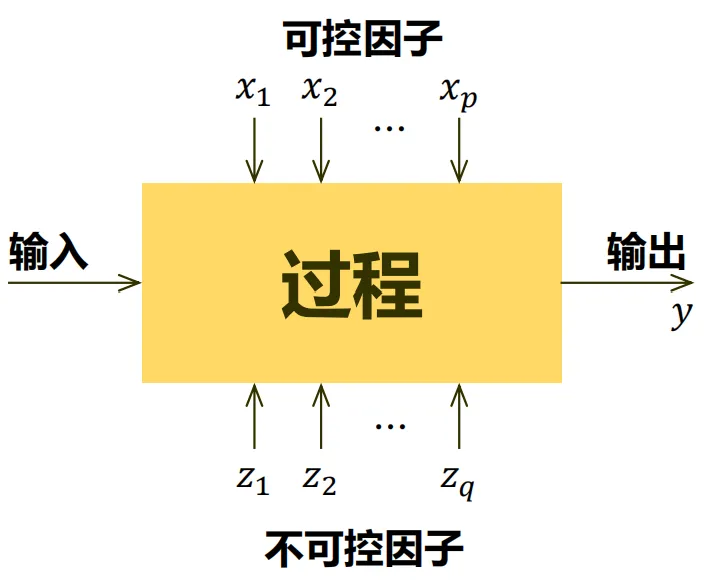
其中输出可以为一个或多个可观测的响应变量,同时应当尽量减小不可控因子的影响
- 经验模型的研究目的:
- 确定哪些变量x对y的影响最大;
- 确定将有影响的变量x设为何值时可以使得y接近期望水平;
- 确定将有影响的变量x设为何值时可以使得y波动性较小;
- 将有影响的变量x设为何值时可以使得不可控因子的影响最小。
- 常见的试验设计策略如下:
- 最佳猜测法
自主选择任意认为可能有关系的因子组合,每次改变一两个因子水平后重复试验
- 优点:效果通常较好
- 缺点:若最初猜测组合的结果不如预期,则往往需要做多次组合,效率较低(难以直接找到最优组合)
- 一次一因子法
对每个因子选择初始值,每次只改变一个因子,保持其他因子不变
- 优点:解释更直观(完全遵循控制变量)
- 缺点:没有考虑因子间的交互作用(对结果的共同影响)
- 析因实验法
改变多个因子,考虑所有可能的因子取值组合(共2n次试验)
优点:可以充分高效地利用数据(同时研究单因子效应和交互作用)【可考虑与假设检验结合】
缺点:试验次数较多,成本较高
- 分式析因实验法
只对所有可能组合的一个子集作试验(尽量选择因子取值有明显差别的组合)【可节约成本】
实际应用
-
因子筛选(screening)实验(也称为因子表征实验)
- 实验目的:估计因子效应的大小与方向,以及因子间是否存在交互作用
- 一般会采用分式析因实验法
-
过程最优化
- 主要目的:确定能够使结果达到最优的因子的范围
- 实际上,存在相同响应变量的因子取值构成的等值线,它可以看作一种响应曲面(response surface)的投影。【实际难以直接绘制】
- 过程最优化的本质就是通过改变可控因子,不断迭代寻找最优响应曲面的过程。其试验设计方法一般会采用中心复合设计。
试验设计基本原则
基本原理
-
随机化
是统计分析方法的基石,具体表现为:
- 实验材料的分配和实验中各次实验进行的顺序都是随机确定的;
- 统计方法要求观测值(或误差)是独立分布的随机变量,随机化通常能使这一假定有效;
把实验进行适当的随机化还有助于“平均掉”可能出现的外来因子的效应。
-
重复(试验)
即对每个因子水平组合进行独立重复实验,由此可以得到试验误差的估计,并使均值估计更准确(减小方差)。
- 重复试验与重复测量之间的差别:重复实验既反映实验间的变异又反映实验内的变异,重复测量则只反映一次实验内的变异。
-
区组化
用于减少或消除干扰因子带来的影响,并提高试验精度。【这里的干扰因子是指可能影响响应变量的值,但研究不直接感兴趣的因子】
试验设计的准则
试验设计的准则(标准)一般分为以下七步(其中前三步都属于试验前的计划):
-
识别并陈述问题
关键是明确试验的具体目标以及需要解决的问题(与目标紧密相关)
- 试验的基本类型包括:因子筛选或表征、最优化试验、验证试验、探索性试验与稳健性试验。
- 推荐的做法是按照序贯方法设计试验(将大的综合性试验按目标分解为小试验)
-
选择响应变量
一般会考虑将被测特性的平均值或标准差(或同时取二者)作为响应变量。另一方面,测量系统的误差也是一个重要考量,它决定了响应变量的测量次数。
-
选择因子、水平与范围
首先我们对可能有影响的因子进行分类:
上述因子的归类可以通过因果(鱼骨)图进行确定。
-
选择试验设计
包括考虑样本量(重复次数)、为试验安排合适的运行顺序,以及确定是否涉及区组化或其他随机化限制。除此之外,设计的选择还涉及考虑和选定一个初步的经验模型来描述结果。
-
实施试验
-
统计分析数据
-
结论与建议
如果对实验数据不满意,可以进行后续实验。随着试验计划的推进,我们常常剔除一些输入变量、加入另一些变量、改变某些因子的探索区域,或者增加新的响应变量等。
试验设计简史
- 1920s(农业时期):Fisher提出试验设计基本原理,在试验结果分析中引入统计方法;
- 1930s(工业时期):以Box为代表人物,将试验设计融入工业试验中;
- 1970s(第三时期):以田口玄一为代表人物,引入多种概念,完善了试验设计理论;
- 1980s至今(后田口时期):对田口方法的质疑与改进。
简单比较试验
本章大部分概念已经在数理统计Cheat Sheet中有所涉及,故这里仅作简单提及,具体细节作略。
简单比较试验只要用于比较两种处理(或某一因子的两个水平)对结果的影响。
样本分布的表示方法
- (一维)点图:只适用小样本数据(主要用于观察总体中心与分散程度)
- 直方图:适用中等数量样本数据(更直观地展示数据分布形状)
- 箱线图:使用大样本数据(一般用五数概括表示,有时也会标注离群值)
完全随机化设计
对于简单比较试验,一种直接的处理是实验单位随机分配到处理组,并假定单位间相互独立,这也被称为完全随机化试验设计。设第一个因子水平的观测值为y11,⋯,y1n1,第二个因子水平的观测值为y21,⋯,y2n2。
- 数学模型:yij=μi+ϵij,i=1,2,j=1,2,⋯,ni
- 其中yij表示第i个因子水平的第j次观测,μi表示第i个因子水平的响应值,ϵij表示随机误差(服从N(0,σi2))【因此yij∼N(μi,σi2)】
- 可用正态概率图(或正态性检验)对样本正态性进行检验【见数理统计】
- 假设检验:H0:μ1=μ2vsH1:μ1=μ2
- 方差相同时:检验统计量t0=spn11+n21y1−y2∼t(n1+n2−2),其中sp2=n1+n2−2(n1−1)s12+(n2−1)s22
- 方差不同时:检验统计量t0=n1s12+n2s22y1−y2∼⋅t(v),其中v=n1−1(s12/n1)2+n2−1(s22/n2)2(n1s12+n2s22)2。
当然,方差已知时若认为总体服从正态分布/样本量足够大,那么也可用两样本z检验,此处作略。
- 样本量的确定:假设两组实验样本量均为n,那么n可由下述三种方法确定:
- 计算统计量在指定置信度水平下的置信区间(随n的变化),一般在拐点附近确定样本量;
- 操作特性曲线(也称OC曲线):即第二类错误β关于样本统计量θ的变化曲线。一般在给定θ条件下,β会随着n增大而减小。
- 功效曲线:即1−β关于θ的变化曲线。【在统计软件中更常用,属于功效分析】
配对比较设计
完全随机化设计存在的问题:将所有的差异都归为随机误差,而未考虑样本间的固有差异(如批次差异,实验个体差异等),从而会导致需要更大的样本量才能达到较好的功效。
- 为解决这一问题,一种方案是按某个与响应变量相关的变量,将实验单元配成相似的对,然后在每对内部随机分配两种处理。这便是配对比较设计。
- 数学模型:yij=μi+βj+ϵij,i=1,2,j=1,2,⋯,n
- 与上面的随机化设计模型唯一区别在于增加了第j个样本对结果的影响因子βj。
- 记d=μ1−μ2,则假设为:H0:d=0vsd=0
- 实际上,配对比较设计是随机区组设计(RBD)的一种特例。这里的区组表示一组相对齐同的一组样本。
- 随机区组设计在完全随机化设计的基础上增加了限制:只能在区组内进行随机化。我们将在后面对此详细讨论。
- 另一方面,与完全随机化设计相比,配对比较设计在消除区组间的变异影响的同时也减小了模型的自由度。【因此区组化可以视作一种降噪设计技术】
- 关于是否要使用区组化设计,还是需要对区组内变异与区组间的变异进行比较。【关于区组化设计的更多内容下面会具体展开】
关于样本的方差推断,一般采用F检验,这里同样作略。
单因子试验:方差分析
这里我们将简单比较试验的两个因子水平推广到任意a个因子水平(或a个处理),使用方差分析法进行比较。
- 如果直接对不同因子水平两两比较,则需要(2a)次比较(假设检验),效率低且会导致第一类错误(实际水平相等但认为存在差异)概率上升。
方差分析(ANOVA)
方差分析适用的数据典型形式如下:
| 处理(水平) |
观测值 |
|
|
|
合计 |
平均 |
| 1 |
y11 |
y12 |
⋯ |
y1n |
y1. |
y1. |
| 2 |
y21 |
y22 |
⋯ |
y2n |
y2. |
y2. |
| ⋮ |
⋮ |
⋮ |
⋱ |
⋮ |
⋮ |
⋮ |
| a |
ya1 |
ya2 |
⋯ |
yan |
ya. |
ya. |
|
|
|
|
|
y.. |
y.. |
其一般服从完全随机化设计(即试验按随机顺序进行,让试验环境尽量均匀)。在对观测值进行建模时,一般使用下述两种模型(可互相转化):
- 均值模型:yij=μi+ϵij,i=1,2,⋯,a, j=1,2,⋯,n
- 其中ϵij为随机误差分量,包含所有的变异,一般认为均值为0(这样E(yij)=μi)。
- 效应模型:yij=μ+τi+ϵij,i=1,2,⋯,a, j=1,2,⋯,n
- 其中μ为总均值,τi为第i个处理(水平)的效应(反映施加具体处理时对μ的偏离)。
- 在假设检验中,一般认为ϵij∼N(0,σ2),这样yij∼N(μ+τi,σ2)。【同时也假定观测值相互独立】
均值模型与效应模型都属于线性统计模型(同时也属于单因子ANOVA模型),其中效应模型在试验设计中更为常见。【因此下述方差分析主要使用效应模型】
- 在处理效应上,线性统计模型也分为固定效应模型与随机效应模型。
- 固定效应模型认为试验的a个处理(水平)是设计者特意选定的,因而结论只适用于选定的因子水平(不能直接推广)。其主要用于估计固定参数(μ,τi,σ2)。
- 随机效应模型(也称方差分量模型)认为试验的a个处理(水平)是从总体随机抽取的样本(即认为τi或μi是随机变量)。其主要用于对随机变量的变异(方差)进行估计。
固定效应模型的分析
设每个处理(水平)的观测值均为n,总观测值数量即为N=an。对于固定效应模型,我们关心的就是a个处理的均值E(yij)=μ+τi=μi,i=1,2,⋯,a是否相等。
-
具体而言,我们构建下述假设(均值模型):
H0:H1:μ1=μ2=⋯=μaμi=μj, ∃(i,j)∈{1,⋯,a}×{1,⋯,a}
而在效应模型中,记总均值μ=a∑i=1aμi,那么i=1∑aτi=0。此时上述假设可以等价表述为:
H0:H1:τ1=τ2=⋯=τa=0τi=0, ∃i∈{1,⋯,a}
-
对这个假设进行检验的方法即为方差分析。首先,我们需要考虑将总变异进行分解。这里的总变异即为总矫正平方和:
SST=i=1∑aj=1∑n(yij−y..)2
实际上,N−1SST即为样本方差。对SST进行分解:
SST=i=1∑aj=1∑n(yij−y..)2=i=1∑aj=1∑n[(yi.−y..)+(yij−yi.)]2=SSTrtni=1∑a(yi.−y..)2+SSEi=1∑aj=1∑n(yij−yi.)2
这样将SST分解为处理平方和(SSTrt)和误差平方和(SSE)。
- SST的自由度为N−1,处理平方和的自由度为a−1,误差平方和的自由度则为a(n−1)=N−a。
- 实际上,由于n−11j=1∑n(yij−yi.)2, i=1,2,⋯,a就是第i个处理的观测值方差(记作Si2),因此
N−aSSE=(n−1)+(n−1)+⋯+(n−1)(n−1)S12+(n−1)S22+⋯+(n−1)Sa2
即为a个处理各自内部方差σ2的合并估计。
- 另一方面,如果H0成立(处理均值间没有差异),那么
a−1SSTrt=a−1n∑i=1a(yi.−y..)2
也是σ2的一个无偏估计。【因为y1.,⋯,ya.可看作方差为nσ2的样本】
- 我们记N−aSSE≜MSE, a−1SSTrt≜MSTrt,那么有
E(MSE)=σ2,E(MSTrt)=σ2+a−1n∑i=1aτi2
这样我们就能通过比较E(MSE)与E(MSTrt)对假设进行检验。
-
可以证明:
σ2SST∼H0χ2(N−1),σ2SSE∼χ2(N−a)
而当H0成立时,σ2SSTrt∼χ2(a−1)。又由Cochran定理(略)可以证明σ2SSTrt与σ2SSE相互独立,于是我们就能得到F统计量
F0=SSE/(N−a)SSTrt/(a−1)=MSEMSTrt∼F(a−1,N−a)
又因为MSTrt在备择假设中期望大于MSE,故使用右尾检验:若F0>Fα(a−1,N−a)(上α百分位数),那么就拒绝原假设。【也可用p值检验】
-
上述的平方和可以进行如下简化计算:
SSTSSTrt=i=1∑aj=1∑nyij2−Ny..2=n1i=1∑ayi.2−Ny..2,SSE=SST−SSTrt
最终得到单因子固定效应ANOVA分析表:
| 变异来源 |
平方和 |
自由度 |
均方 |
F0 |
| 处理之间 |
SSTrt=ni=1∑a(yi.−y..)2 |
a−1 |
MSTrt |
F0=MSEMSTrt |
| 误差(处理内部) |
SSE=SST−SSTrt |
N−a |
MSE |
|
| 总计 |
SST=i=1∑aj=1∑n(yij−y..)2 |
N−1 |
|
|
单因子固定效应模型参数估计
- 总均值和处理效应的合理估计由下式给出:
μ^=y..,τ^i=yi.−y.., i=1,2,…,a
当然,也可以对均值模型中的μi进行点估计:μ^i=μ^+τ^i=yi.。
- 假定ϵij服从正态分布,那么若σ2已知,可以用正态分布刻画置信区间。若用MSE估计σ2,那么可以用t分布刻画置信区间:
μiμi−μj:[yi.−tα/2(N−a)nMSE, yi.+tα/2(N−a)nMSE]:[yi.−yj.−tα/2(N−a)n2MSE, yi.−yj.+tα/2(N−a)n2MSE]
而在实际情况中,往往会计算多个均值(差)的置信区间。如果有r个置信度水平为1−α的置信区间,那么它们同时覆盖真值的概率至少为1−rα。(rα也被称为试验误差率或总置信系数)
- 当r增大时,总的置信水平就会下降。对此,可以采用Bonferroni方法:将每个置信区间的置信水平从1−α改为1−rα。【此时置信区间变宽】
- 对于不平衡数据(即每个处理的观测值数量不同),上述ANOVA方法仍然使用,只需要对平方和公式稍作修改。设第i条处理的观测值数量为ni(i=1,2,⋯,a),N=i=1∑ani,则:
SSTSSTrt=i=1∑aj=1∑niyij2−Ny..2=i=1∑aniyi.2−Ny..2
当然,一般而言平衡数据往往更好。因为其对假定的等方差偏离不敏感,且检验功效最大。
模型合适性检验
在选择模型时,需要对数据是否适合用该模型表述进行检验。比如,若选择效应模型,就需要检验数据能否用yij=μ+τi+ϵij表述,且误差为均值0,方差为未知常数的正态随机变量。对此,我们主要考察残差进行研究。
- 定义残差:eij=yij−y^ij。其中y^ij为观测值yij的估计值,计算公式为:
y^ij=μ^+τ^i=y..+(yi.−y..)=yi.
- 首先需要对残差进行正态性检验(残差eij∼N(0,σ2(1−ni1))),主要采用正态概率图。具体示意图如下:
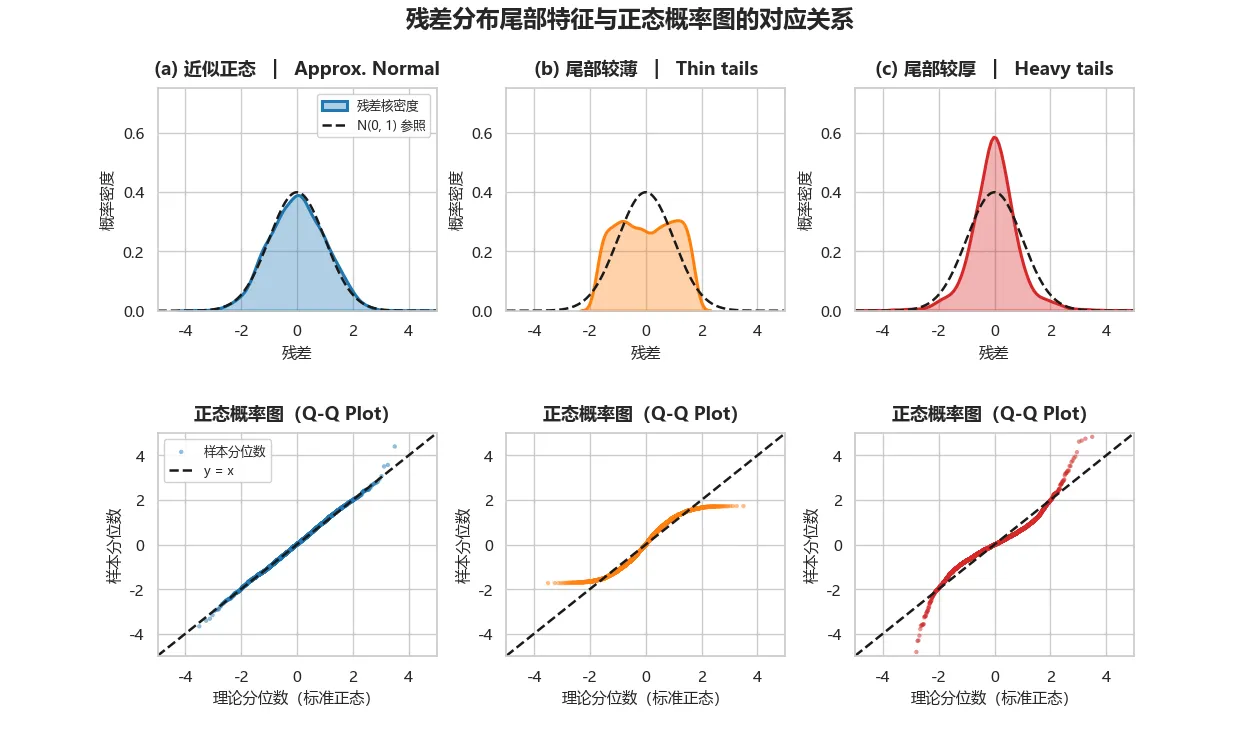
一般来说,在固定效应方差分析中,中度偏离正态性关系不大;随机效应模型受非正态性的影响则要严重得多。
- 使用正态概率图检验时需要注意离群值的影响(会严重影响ANOVA结果)。可以用标准化残差dij=MSEeij粗略检查离群值。【方差近似为1】
注意不能直接使用正态性检验(如A-D检验)的结果,因为这些检验假定数据独立,但残差并不独立。
- 其次,如果将残差按时间顺序绘制,可以考察残差在时间上的自相关性。如果出现正残差与负残差成串交替的倾向,说明存在正相关,这就违背了残差在时间上的独立性假定。
- 除此之外,残差的方差稳定性(方差齐性)也是另一个重要的检验方面。在某些情况下,残差对时间的图形呈现出一端的散布比另一端更大,这便是非常数方差问题。
- 我们也可以让残差对拟合值y^ij作图。如果观测值的方差会随着观测值大小的增大而增大,那么在图上会呈现为一个向外张开的漏斗或喇叭,这也属于非常数方差。
- 在非平衡设计中,非常数方差的影响会更大。
- 解决非常数方差问题的一般方法是使用方差稳定化变换。
- 如果试验者知道观测值的理论分布,就可以利用这一信息来选择变换。(如泊松分布对应平方根变换,对数正态分布对应对数变换等)
- 当然也可以从数据凭经验选择变换。具体而言,设E(y)=μ,标准差σy∝μα,那么只需要作变换y∗=y1−α即可。
- α的估计:可以绘制logσyi关于logμi的曲线,其拟合出直线的斜率即为α的估计。【一般用Si和yi.估计σyi和μi】
- 除此之外,还有一种Box-Cox变换,这里不详细展开。
- 方差齐性检验的假设形式为:H0:σ12=σ22=⋯=σa2vsH1:至少一个σi2不满足这一关系。
- 一般会采用Bartlett检验(对正态性假定敏感)或修正 Levene 检验(更加稳健)。
均值比较方法
在ANOVA的基础上,如果拒绝原假设(均值间存在差异),我们希望在此基础上进一步研究哪些均值间存在差异。这一类方法通常称为多重比较方法。
- 最直接的方法是图形比较。若均值间没有差异,那它们可以看作独立同分布的随机样本,标准差为nσ。于是可以直接拿正态分布沿均值轴滑动,若假设成立则均值能被同一个分布包裹住(设定显著性水平)。
- 实际中σ往往未知,此时可用MSE替代,并用t分布代替正态分布。
- 这一方法比较粗略,更精确的方法是使用对照:
对照
- 定义:设待比较参数为μ1,⋯,μa,那么对照就是形如Γ=i=1∑aciμi的组合,其中i=1∑aci=0。由此可将假设归纳为H0:Γ=0vsH1:Γ=0。对这一假设进行检验的方法主要有下述两种:
- t检验:记C=i=1∑aciyi.,则C∼N(i=1∑aciμi,σ2i=1∑anci2)(假设数据平衡),因此
Z=nσ2i=1∑aci2C−i=1∑aciμi∼N(0,1)
当σ2未知时,用MSE替代,从而得到t检验统计量
t0=nMSEi=1∑aci2C∼t(N−a)
若∣t0∣>t2α(N−a)即拒绝原假设。
- F检验:只需将上述t0取平方,得到F0=t02∼F(1,N−a),然后F0>Fα(1,N−a)时拒绝原假设。
- 实际上这里的F0可以表示为F0=MSESSC/1,其中SSC=n1∑i=1aci2C2称为对照平方和。
- 当然我们也能构造Γ的置信区间:
i=1∑aciyi.−t2α(N−a)nMSEi=1∑aci2≤Γ≤i=1∑aciyi.+t2α(N−a)nMSEi=1∑aci2
- 另一方面,为了让对照的方差统一为σ2,可以考虑将C转化为标准化对照
C∗=i=1∑aci∗yi.=i=1∑an1∑i=1aci2ciyi.
- 对于不平衡数据,对照的约束需要改为i=1∑anici=0,相应的t0和对照平方和也需要改为
t0=MSEi=1∑anici2i=1∑aciyi.,SSC=i=1∑anici2(i=1∑aciyi.)2
- 下面讨论一种特殊的对照性质:正交对照。具体而言,如果系数{ci}和{di}满足i=1∑acidi=0(非平衡数据则为i=1∑anicidi=0),则称对应的两个对照正交。
- 实际上,处理平方和SSTrt可以分解为a−1个相互正交的对照平方和。于是我们就能将均值比较转化为正交对照的比较。
- 正交对照需要在试验之前就确定好,否则如果等到得到观测数据后再选择比较,就会产生数据窥探问题,放大第一类错误。
多重比较方法
- 在确定好对照后,如何进行多重比较检验呢?历史上统计学家们提出了多种方法,包括(按提出时间排序):
- Fisher LSD(最小显著性差异)方法
检验统计量定义为t0=MSE(ni1+nj1)yi.−yj.,若∣t0∣>t2α(N−a)则拒绝原假设H0:μi=μj。
- 这里的LSD定义为LSD=t2α(N−a)MSE(ni1+nj1),因此上述检验本质是均值差与LSD的比较。
- 相比其他多重比较方法而言,Fisher LSD方法的判定更加宽松,更容易得到有显著差异结论。【因此相应地第一类错误率也更高】
- Bonferroni方法
和前面的置信区间估计一样,设比较次数为m,则将每个比较的显著性水平α调整为mα即可。它与Fisher LSD方法恰好处于两个极端,严格控制了第一类错误率,但也使得统计功效偏低。
- Tukey方法
也称Tukey’s HSD(诚实显著性差异)检验,其检验统计量基于极差统计量q=MSE/nymax−ymin,其中ymax和ymin分别为处理的最大与最小均值。由此得到HSD临界值qα(a,f)nMSE(f为MSE自由度),若均值差超过这一临界值则认为有显著差异。
- 对于不平衡数据,临界值根号内改为2MSE(ni1+nj1),此时也称为Tukey-Kramer检验。
- Dunnett法
Dunnett法处理的场景与前面几种有所不同,其主要用于单个对照与其余a−1个处理均值的比较。其核心公式为
∣yi.−ya.∣>dα(a−1,f)MSE(ni1+na1)
若某个处理均值满足上述条件则判定其与对照均值有显著差异。
- Scheffé法
Scheffé法的适用场景与上述方法又不一样,它可以用于比较任意多对照的均值。具体而言,考虑下述m个对照
Γu=c1uμ1+c2uμ2+⋯+cauμau=1,2,…,m
对应的估计值为
Cu=c1uy1.+c2uy2.+⋯+cauya.u=1,2,…,m
构造其标准误SCu=MSEi=1∑a(ciu2/ni),那么可以得到临界值Sα,u=SCu(a−1)Fα,a−1,N−a,当∣Cu∣>Sα,u时拒绝原假设H0:Γu=0。
- 当然,Scheffé法通用性的代价就是其在两两简单比较上统计功效最低。
位置效应与离散效应
前面我们探讨的因子水平对响应变量均值的影响也被称为位置效应,而有时我们也会探究因子水平对响应变量变异(如方差)的影响,这被称为离散效应。
- 在探究离散效应时,一般将log(s)或logs2(或者相反数)作为相应变量,这可以有效地稳定样本标准差分布中的变异。其余分析与前面的方差分析一致。
随机效应模型
随机效应线性统计模型可以表示为
yij=μ+τi+ϵiji=1,2,⋯,a,j=1,2,⋯,n
其中τi∼N(0,στ2),ϵij∼N(0,σ2)且均相互独立。由此可得Var(yij)=στ2+σ2,故这个模型也称为方差分量模型。另一方面,任意两个观测值的协方差为
Cov(yij,yij′)=στ2,j=j′Cov(yij,yi′j)=0,i=i′
即不同处理观测值相互独立,而同一处理下观测值条件独立(在试验完成,τi确定后相互独立)。
- 对随机效应模型的方差分析同样可以采用平方和分解SST=SSTrt+SSE。当然,与固定效应方差分析不同,随机效应方差分析主要关注方差分量假设
H0:στ2=0vsH1:στ2=0
若原假设成立,那么就不认为存在随机效应。其假设检验采用F统计量F0=MSEMSTrt,在H0成立时服从F(a−1,N−a)。另外,可以证明
E(MSTrt)=σ2+nστ2,E(MSE)=σ2
因此F0>Fα(a−1,N−a)时拒绝H0。
随机效应模型的参数估计
由上述期望表达式可得στ2和σ2的无偏估计分别为
σ^2=MSE,σ^τ2=nMSTrt−MSE
对于不平衡数据,只需将n替换为n0=a−11[i=1∑ani−∑i=1ani∑i=1ani2]即可。
- σ2的(1−α)置信区间则为
χα/2,N−a2(N−a)MSE≤σ2≤χ1−(α/2),N−a2(N−a)MSE
- 我们无法构造精确的στ2的置信区间,但可以构造στ2+σ2στ2的(这也被称为组内相关系数):
1+LL≤στ2+σ2στ2≤1+UU
其中
L=n1(MSEMSTrtF2α(a−1,N−a)1−1),U=n1(MSEMSTrtF1−2α(a−1,N−a)1−1)
实际上[L,U]就是σ2στ2的1−α置信区间。
- 关于总均值μ,其方差可以用anMSTrt来估计,置信区间为
y..−t2α(a−1)anMSTrt≤μ≤y..+t2α(a−1)anMSTrt
随机区组及拉丁方设计
上面我们提到,随机化的作用是抑制干扰因子的影响。当干扰变异源已知且可控时,可以采用区组化方法系统地消除它对处理之间统计比较的影响。
- 在区组化的设计下,如果仍然采用上述完全随机化试验方法,会使试验误差同时包含随机误差与干扰因子的变异,导致二者无法区分。对此,我们引入随机完全区组设计(RCBD),其将干扰因子作为区组因子,并使每个区组(作为试验单元)包含所有处理。
在一定程度上,RCBD可以看作配对比较试验的推广。
随机完全区组设计
随机完全区组设计的一般形式:a个处理,b个区组,每个区组中的每个处理都有一个观测值,而每个区组内处理实施的顺序是随机确定的。
-
RCBD的(固定)效应模型:yij=μ+τi+βj+ϵij,i=1,⋯,a,j=1,⋯,b,其中τi为处理效应,βj为区组效应,分别满足i=1∑aτi=0,j=1∑bβj=0。
-
RCBD的检验假设:各处理均值是否相等,即H0:τ1=⋯=τa=0vsH1:存在一个τi=0
-
RCBD方差分析:
SST=i=1∑aj=1∑b(yij−y..)2=i=1∑aj=1∑b[(yi.−y..)+(y.j−y..)+(yij−yi.−y.j+y..)]2=SSTrtbi=1∑a(yi.−y..)2+SSBlkaj=1∑b(y.j−y..)2+SSEi=1∑aj=1∑b(yij−y.j−yi.+y..)2
对应的自由度:
| 平方和 |
自由度 |
| SST |
N−1=ab−1 |
| SSTrt |
a−1 |
| SSBlk |
b−1 |
| SSE |
(a−1)(b−1) |
平方和快速计算方法:
SSTSSE=i=1∑aj=1∑byij2−Ny⋅⋅2SSTrt=b1i=1∑ayi⋅2−Ny⋅⋅2SSBlk=a1j=1∑by⋅j2−Ny⋅⋅2=SST−SSTrt−SSBlk
-
同样由Cochran定理可得,σ2SSTrt,σ2SSBlk,σ2SSE为相互独立的卡方随机变量,且均方期望分别为
E(MSTrt)=σ2+a−1b∑i=1aτi2,E(MSBlk)=σ2+b−1a∑j=1bβj2,E(MSE)=σ2
检验统计量仍然为F0=MSEMSTrt∼H0F(a−1,(a−1)(b−1))。
-
当然,我们也可以考虑对区组均值的假设H0:β1=⋯=βb=0(如果不拒绝原假设,那就无需区组化)进行检验。不过对于检验统计量的选择存在争议,直接用F0=MSEMSBlk不太能视作精确检验方法,只能用于粗略评估。
-
RCBD参数估计:
⎩⎨⎧μ^=y..τ^i=yi.−y..β^j=y.j−y..⟹y^ij=yi.+y.j−y..
-
RCBD模型合适性检验:可以沿用上述多重比较方法(只需将n换为b,同时误差自由度改为(a−1)(b−1))。
-
残差分析:对于残差eij=yij−y^ij,除了绘制正态概率图外,也可以绘制其按处理/区组分类的分布图。
- 另一方面,还可以绘制残差对观测值的分布图,如果图像呈现出某种曲线,那么说明区组与处理间存在交互作用,此时应对观测值施加变换以消除这种作用。
-
RCBD模型可加性:由于随机区组模型没有区组处理交互项,因此区组效应与处理效应在线性预测上可以相加。也就是说,各区组中不同处理的差异保持恒定,区组只对每个处理造成一个相同的常数平移。
- 如果模型不满足可加性(处理效应与区组有关),会放大误差均方,并可能对处理均值的比较产生不利影响。一种解决方法是进行尺度变换(如对数变换),不过更多情况下会考虑因子设计。【后面会详细展开】
-
RCBD随机效应模型:在实际情况中,区组往往是随机因子,即β1,⋯,βb∼i.i.d.N(0,σβ2),而处理为固定因子。此时可得
E(yij)Var(yij)Cov(yij,yi′j′)Cov(yij,yi′j)=μ+τi,i=1,2,…,a=σβ2+σ2=0,j=j′=σβ2,i=i′
而期望均方为
E(MSTrt)E(MSBlk)E(MSE)=σ2+a−1b∑i=1aτi2=σ2+aσβ2=σ2
所以检验统计量同上。同时σβ2的估计为σ^β2=aMSBlk−MSE。
另一方面,上述F统计量实际上也适用于处理与区组存在交互的模型。【推导略】
-
缺失值估计:使用RCBD时,有时某个区组中会有一个观测值缺失。对此一般有两种处理方法:
- 近似分析:先估计缺失的观测值,然后像这些估计值就是真实数据一样进行通常的方差分析,并把误差自由度减1。
- 缺失观测值的估计(使SSE最低):x^=(a−1)(b−1)ayi.′+by.j′−y..′【带′表示去掉缺失值后的总和】
- 精确分析:使用一般回归显著性检验【略】
拉丁方设计