潜在狄利克雷分配
-
潜在狄利克雷分配(latent狄利克雷allocation, LDA)于2002年由Blei等提出。它和概率潜在语义分析都属于概率主题建模方法,二者之间的差异恰好反映了频率学派与贝叶斯学派对参数估计上的不同理解:
- PLSA将模型参数看作是固定的未知常数,使用类似点估计的方法进行参数估计;
- LDA则将模型参数看作是服从特定分布的随机变量,引入了狄利克雷先验分布,并通过观察到的数据来修正这个先验,得到后验分布。
研究表明,虽然LDA更加复杂,但其模型性能比PLSA更好,泛化能力也更强。
狄利克雷分布
简要回顾一些概率论与数理统计的知识:
- 多项分布
重复进行n次独立随机试验,每次试验可能出现的结果有k种,第i种结果出现的概率为θi,出现的次数为ni。
- 如果用随机变量x=(x1,x2,⋯,xk)⊤表示试验所有可能结果的次数(其中xi表示第i种结果出现的次数),那么随机变量x服从多项分布,对应概率密度函数为
P(x1=n1,x2=n2,⋯,xk=nk)=n1!n2!⋯nk!n!θ1n1θ2n2⋯θknk=i=1∏kni!n!i=1∏kpini
也记作x∼Mult(n,θ),其中θ=(θ1,⋯,θk)⊤,n=i=1∑kni。
- 特别地,当n=1时,多项分布退化为类别分布,表示表示试验可能出现的k种结果的概率。
- 狄利克雷分布
在贝叶斯学习中,狄利克雷分布常作为多项分布的先验分布使用。其定义如下:
- 若多元连续随机变量θ=(θ1,θ2,⋯,θk)⊤的概率密度函数为
p(θ∣α)=i=1∏kΓ(αi)Γ(i=1∑kαi)i=1∏kθiαi−1
其中
i=1∑kθi=1,θi≥0,α=(α1,α2,⋯,αk)⊤,αi>0,i=1,2,⋯,k
Γ(⋅)表示Gamma函数,则称随机变量θ服从参数为α的狄利克雷分布,记作θ∼Dir(α)。
- 上述概率密度函数表达式也可用多元Beta函数表示:记B(α)=Γ(i=1∑kαi)i=1∏kΓ(αi),则有
p(θ∣α)=B(α)1i=1∏kθiαi−1
特别地,当k=2时,就得到Beta分布。
- 狄利克雷分布有一些重要性质:
- 狄利克雷分布属于指数分布族;
- 狄利克雷分布是多项分布的共轭先验分布。【共轭先验分布概念可参见数理统计 Cheat Sheet】
- 具体而言,当总体分布D∼Mult(n,θ),θ先验分布为Dir(α),那么其后验分布为Dir(α+n)。因此α也被称作先验伪计数(prior pseudo-counts)。
LDA模型
-
LDA是文本集合的生成概率模型。模型假设话题由单词的多项分布表示,文本由话题的多项分布表示,单词分布和话题分布的先验分布都是狄利克雷分布。
- 严格意义上说,这里的多项分布都是类别分布,不过在机器学习与自然语言处理中,有时对两者不作严格区分。
-
LDA的文本集合的生成过程示意图如下: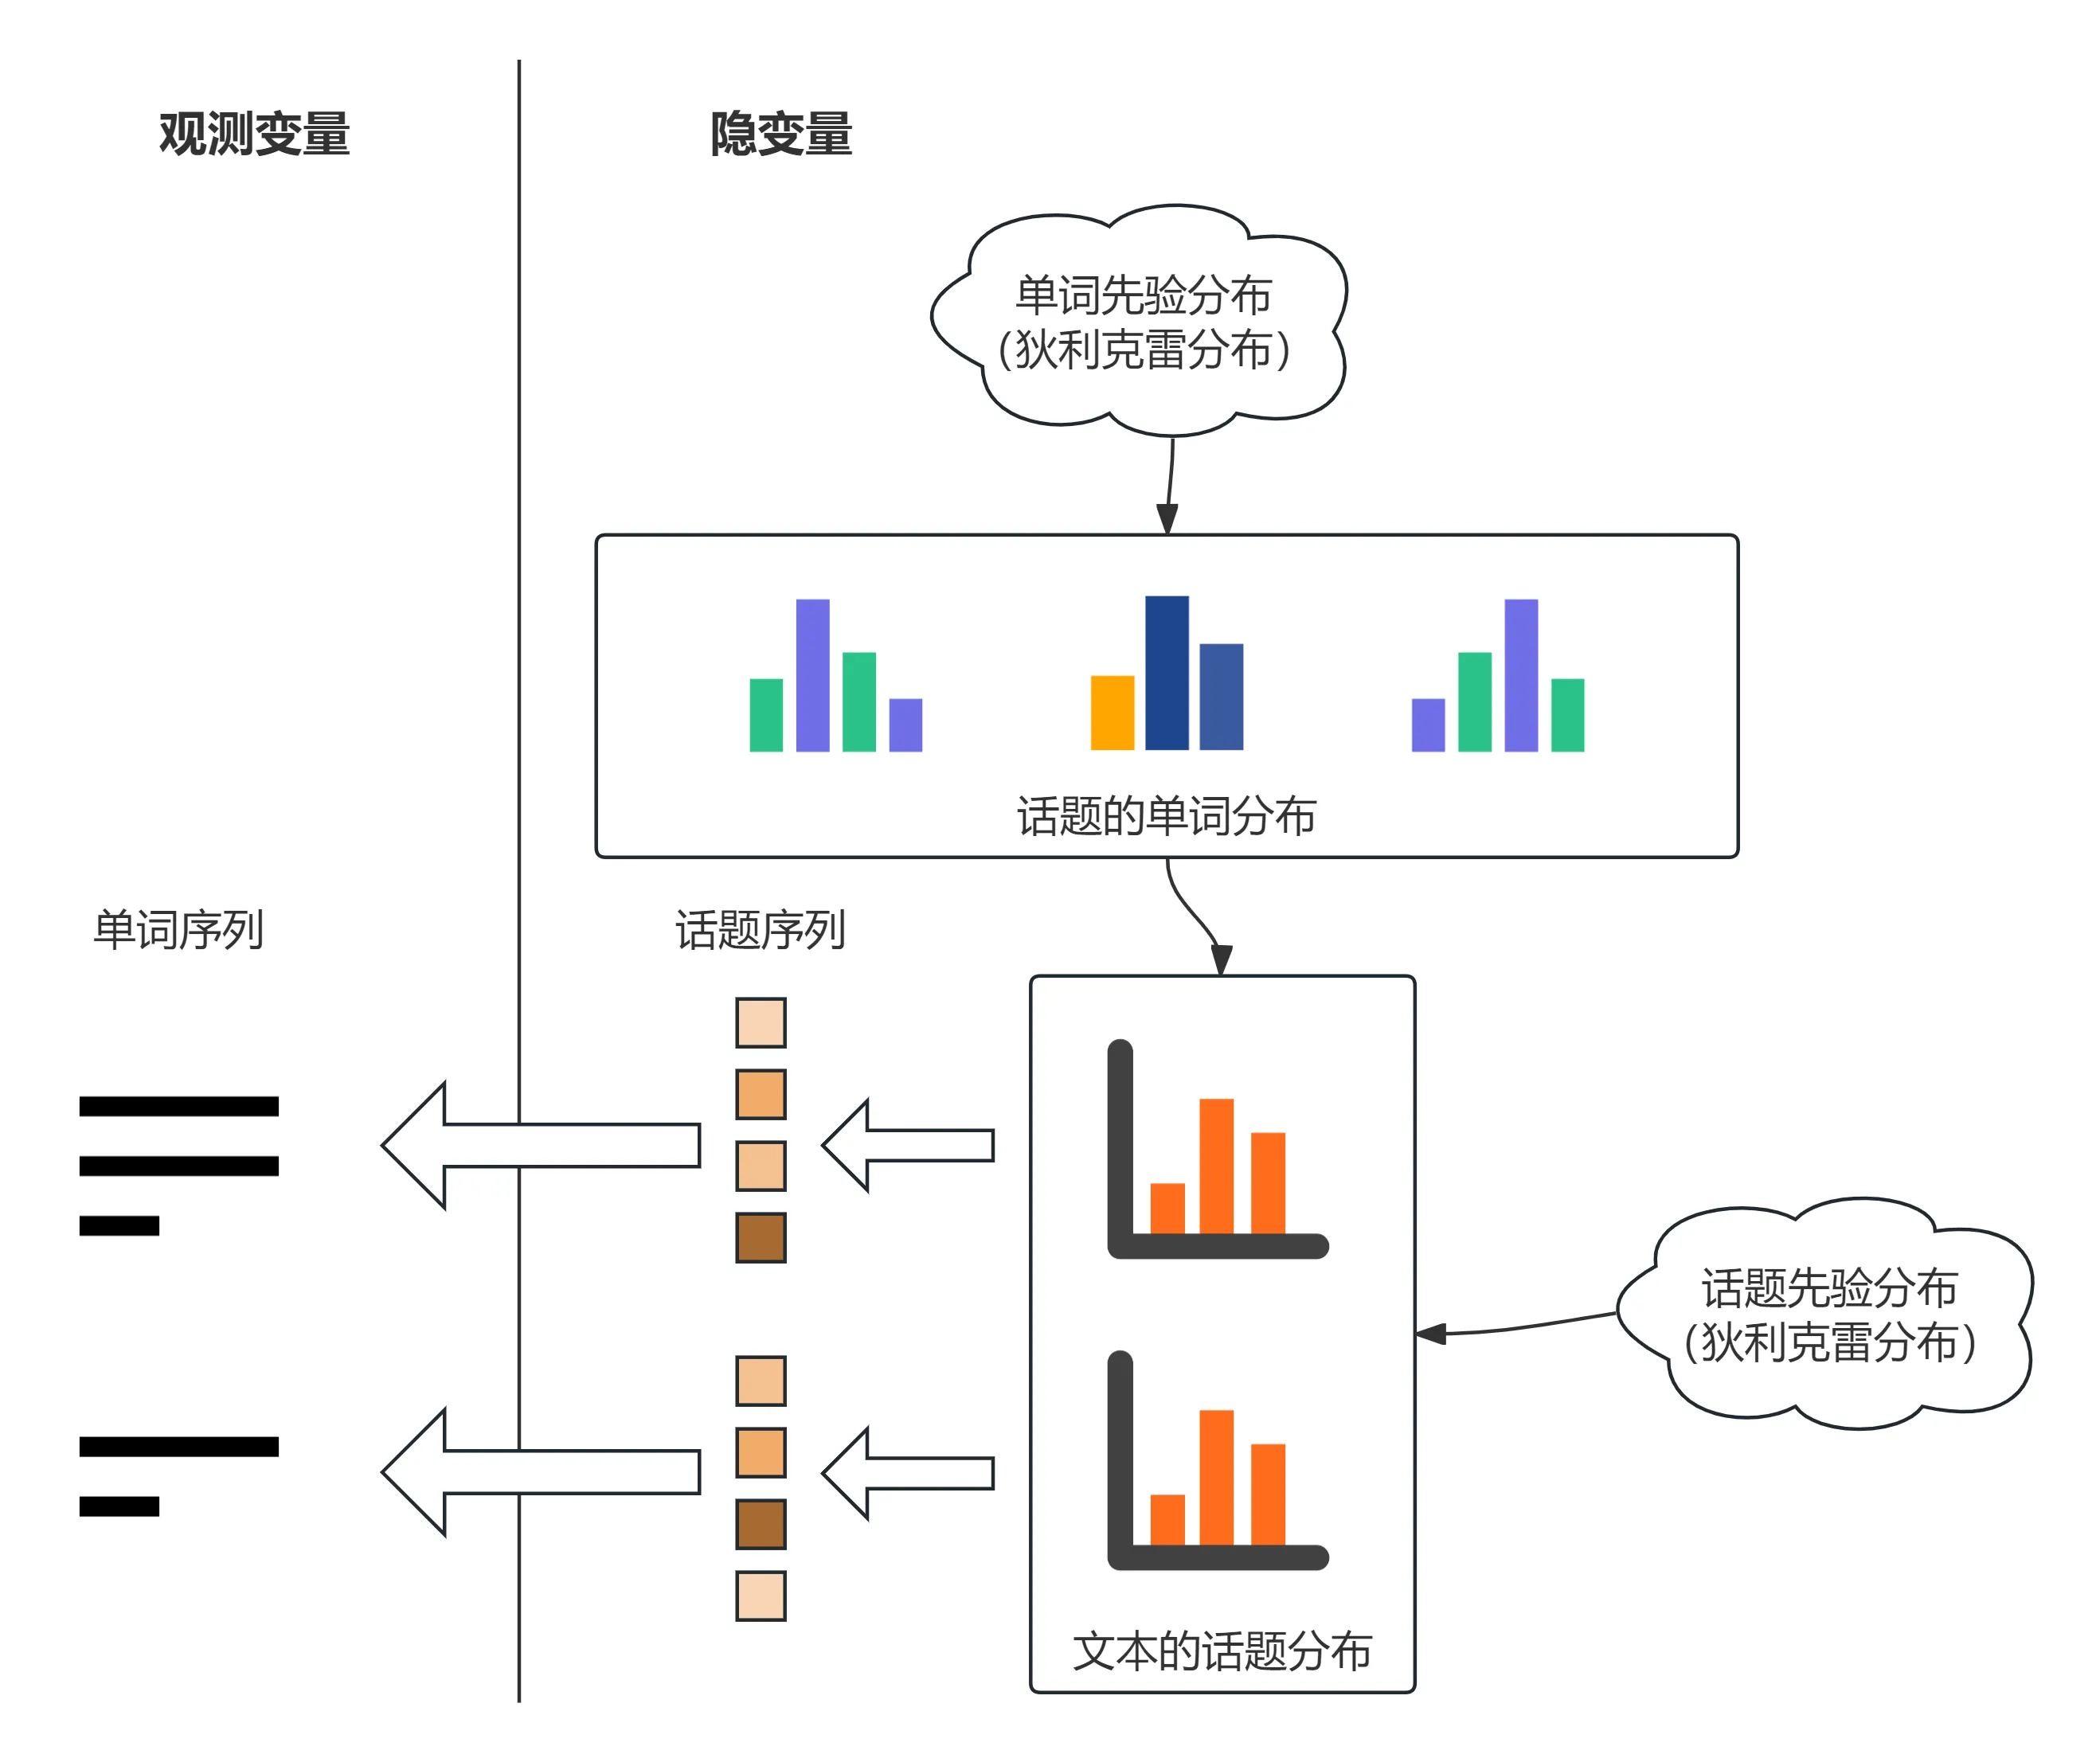
利用LDA进行话题分析就是对给定文本集合,学习到每个文本的话题分布,以及每个话题的单词分布。
-
下面给出模型的符号定义:
- 单词、文本、话题集合符号沿用上一讲;
- 设所有文本的长度均为l,且每个文本di都有对应可观测的单词序列Wi=wi1,⋯,wil与不可观测的话题序列Zi=zi1,⋯,zil;
- 每个话题zi可由单词的条件概率分布P(w∣zi),w∈W表示,其服从多项(类别)分布,参数用φi=(φi1,⋯,φim)表示,因而整个话题的参数可用矩阵φ=(φ1,⋯,φk)表示。【φi∼Dir(β),β=(β1,⋯,βm)⊤】
- 每个文本dj可由话题的条件概率分布P(z∣dj),z∈Z表示,同样服从多项(类别)分布,参数用θi=(θi1,⋯,θik)表示,因而整个文本的参数可用矩阵θ=(θ1,⋯,θn)表示。【θi∼Dir(α),α=(α1,⋯,αm)⊤】
-
由此可得LDA文本生成算法如下:
- 对于话题zi(i=1,2,⋯,k):生成多项分布参数φi∼Dir(β)作为话题的单词分布p(w∣zk)。
- 对于文本di(i=1,2,⋯,n):生成多项分布参数θi∼Dir(α)作为文本的话题分布p(z∣dn)。
- 对于文本di的单词wij(i=1,2,⋯,n,j=1,2,⋯,l):生成话题zij∼Mult(θi)作为单词对应的话题,生成单词wij∼Mult(φzij)作为该话题下的单词。
最终得到文本序列Wi=wi1,wi2,⋯,wil。
- 上述参数中,话题数k一般通过实验确定。狄利克雷分布的超参数α和β通常也是事先给定的。在没有其他先验知识的情况下,可以假设向量α和β的所有分量均为1,此时文本与话题的先验分布均为均匀分布。
-
LDA模型的概率图形式如下: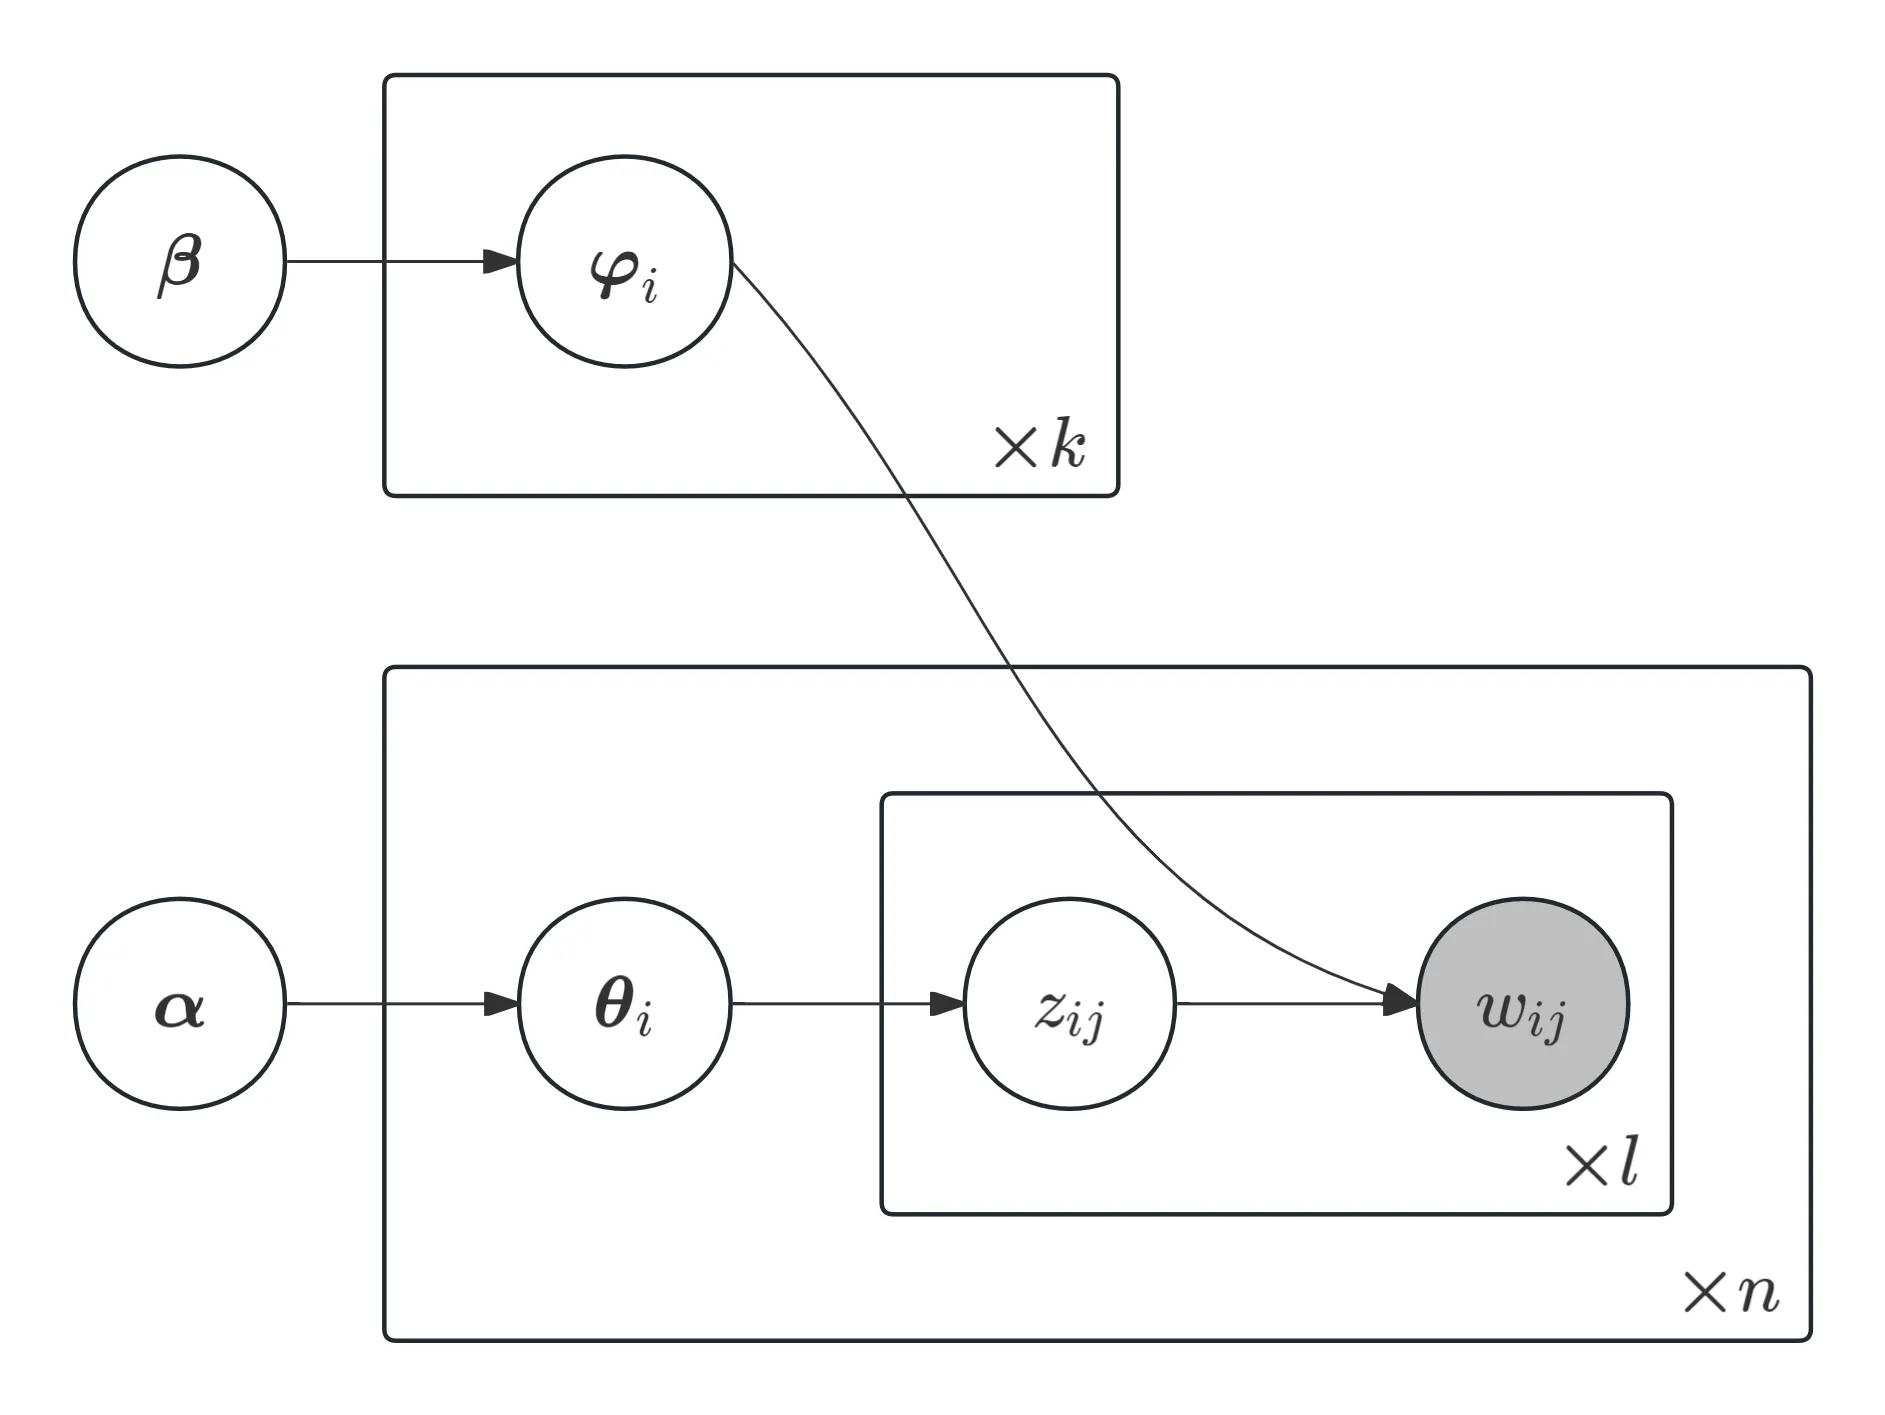
-
LDA假设文本由无限可交换的话题序列组成,即话题序列的任意一个有限子序列的联合概率对随机变量的排列不变。由De Finetti定理知,实际是假设文本中的话题对随机参数(即上面的φ)是条件独立同分布的。
- 实际上,我们也可以证明在给定φ的φ时,文本序列的各个元素都是相互条件独立的。
-
LDA模型的概率计算公式如下:
p(W,Z,θ,φ∣α,β)=t=1∏kp(φt∣β)i=1∏np(θi∣α)j=1∏lp(zij∣θi)p(wij∣φzij)
其中W为所有文本序列集合,Z为所有话题序列集合。如果具体到第i个文本,则概率为
p(Wi,Zi,θi,φ∣α,β)=t=1∏kp(φt∣β)p(θi∣α)j=1∏lp(zij∣θi)p(wij∣φzij)
然后考虑给定文本与话题参数后文本Wi的生成概率:
p(Wi∣θi,φ)=j=1∏l[t=1∑kp(zij=t∣θi)p(wij∣φt)]
将参数替换为超参数α,β,得到
p(Wi∣α,β)=t=1∏k∫p(φt∣β){∫p(θi∣α)p(Wi∣θi,φ)dθi}dφt
最终得到超参数给定条件下所有文本的生成概率:
p(W∣α,β)=t=1∏k∫p(φt∣β){i=1∏n[∫p(θi∣α)p(Wi∣θi,φ)dθi]}dφt
其中t=1∏k∫[…]dφt表示k重嵌套积分。
学习算法
- LDA的学习(参数估计)是一个复杂的最优化问题,很难精确求解,只能近似求解。常用的近似求解方法有吉布斯抽样和变分EM算法。
下面只给出算法的形式,具体阐述请参见下一讲。
吉布斯抽样算法
- 输入:文本的单词序列W=W1,⋯,Wi,⋯,Wn,其中Wi=wi1,wi2,⋯,wil。
- 输出:文本的话题序列Z=Z1,⋯,Zi,⋯,Zn,其中Zi=zi1,zi2,⋯,zil的后验概率分布p(Z∣W,α,β)的样本计数、模型的参数φ和θ的估计值。
- 参数:超参数α和β,话题个数k。
- 设所有计数矩阵的元素nit、ntm,计数向量的元素ni、nt初值为0。
- 对所有文本di(i=1,2,⋯,n),对第i个文本中的所有单词wij(j=1,2,⋯,l),抽样话题zij=zt∼Mult(1/k);增加话题-单词计数ntm=ntm+1,增加话题-单词和计数nt=nt+1,增加文本-话题计数nit=nit+1,增加文本-话题和计数ni=ni+1。
- 循环执行以下操作,直到进入燃烧期:对所有文本di(i=1,2,⋯,n),对第i个文本中的所有单词wij(j=1,2,⋯,l):
- 当前的单词wij是词汇表中第m个单词,话题指派zij是第t个话题;减少计数ntm=ntm−1,nt=nt−1,nit=nit−1,ni=ni−1;
- 按照满条件分布进行抽样:
p(zij=t∣Z−(ij),W,α,β)∝∑m=1M(ntm+βm)ntm+βm⋅∑t′=1k(nit′+αt′)nit+αt
得到新的第t′个话题,分配给zij;
- 增加计数nt′m=nt′m+1,nt′=nt′+1,nit′=nit′+1,ni=ni+1;
- 得到更新的两个计数矩阵Nk×M=[ntm]和Nn×k=[nit],表示后验概率分布p(Z∣W,α,β)的样本计数。
- 利用得到的样本计数,计算模型参数:
φtmθit=m=1∑M(ntm+βm)ntm+βm=t′=1∑k(nit′+αt′)nit+αt
变分EM算法
- 输入:给定所有文本D=(d1,d2,⋯,di,⋯,dn),主题数k,词汇表大小m。
- 输出:变分参数(γ,η),以及完整模型参数:k个主题的词分布矩阵φ={φ1,φ2,⋯,φr,⋯,φk},狄利克雷超参数α。
- E 步(变分参数估计)
固定全局模型参数α,φ,通过最大化证据下界(ELBO),估计变分参数γ,η。
- 初始化:对所有文档i和主题r,令变分狄利克雷参数γir(0)=αr+l/k;对所有位置j和主题r,令变分多项分布参数ηijr(0)=1/k。
- 重复(直到变分参数收敛):
- 对所有文本位置j=1→l,对所有主题r=1→k:
ηijr(t+1)=φr,wij⋅exp[Ψ(γir(t))−Ψ(r′=1∑kγir′(t))]
其中φr,wij是主题r下单词wij的概率,Ψ(⋅)为双伽马函数。(Gamma函数导数)
- 对每个ηijr(t+1)进行归一化,使得r=1∑kηijr(t+1)=1。
- 更新文档-主题变分参数:
γir(t+1)=αr+j=1∑lηijr(t+1)
- M 步(模型参数估计)
固定当前的变分参数γ,η,通过最大化证据下界,估计全局模型参数α,φ。
- 更新词分布矩阵φ:
- 首先计算k个主题的词分布。对于每个主题r∈{1,…,k}和词汇表中的每个单词v∈{1,…,m}:
φrv∝i=1∑nj=1∑lηijr⋅1(wij=v)
- 然后对每个主题r的所有词汇v进行归一化:
φrv=v′=1∑m(βv′+i=1∑nj=1∑lηijr1(wij=v′))βv+i=1∑nj=1∑lηijr1(wij=v)
- 更新超参数α:
- α没有解析解,可以通过牛顿法迭代求解,具体更新步骤如下:
- 计算梯度向量:对每个主题r求导:
∇L(αr)=n[Ψ(r′=1∑kαr′)−Ψ(αr)]+i=1∑n[Ψ(γir)−Ψ(r′=1∑kγir′)]
- 计算黑塞矩阵(Hessian)元素:
∇2L(αrαr′)=n[Ψ′(r′=1∑kαr′)−1(r=r′)Ψ′(αr)]
- 执行牛顿更新迭代:
αnew=αold−[∇2L(αold)]−1∇L(αold)