在《机器学习方法》中,我们已经对机器学习的生成模型(如朴素贝叶斯,GMM,HMM等)有了基本的认识。而随着神经网络与深度学习的发展,基于神经网络的深度生成模型逐渐兴起,其中的代表便是GAN、VAE与扩散模型。它们也是如今生成式人工智能的重要基石。
当然,神经网络与生成模型的结合最早可以追溯到1986年的RBM(受限玻尔兹曼机)和2006年的DBN(深度信念网络),只不过直到2014年左右GAN与VAE的出现才让深度生成模型为人所熟知。
生成对抗网络(GAN)
生成对抗网络于2014年由Ian Goodfellow等人提出。在其后的十余年里,各种变体不断涌现,成为深度生成模型中的一大家族。
- 那么什么是GAN?顾名思义,GAN是一种特殊的神经网络,其通过一种称为对抗的方法进行训练,最终目标是生成数据。
- 具体而言,给定随机向量X∼pX(x),以及随机噪音向量Z∼pZ(z), GAN的目标是找到函数G,使得X~=G(Z)∼pX(x)。
- GAN生成数据可用于生成图片、图片风格转换、图片修补、语音和文本生成等。
模型与算法
-
GAN的具体结构如下: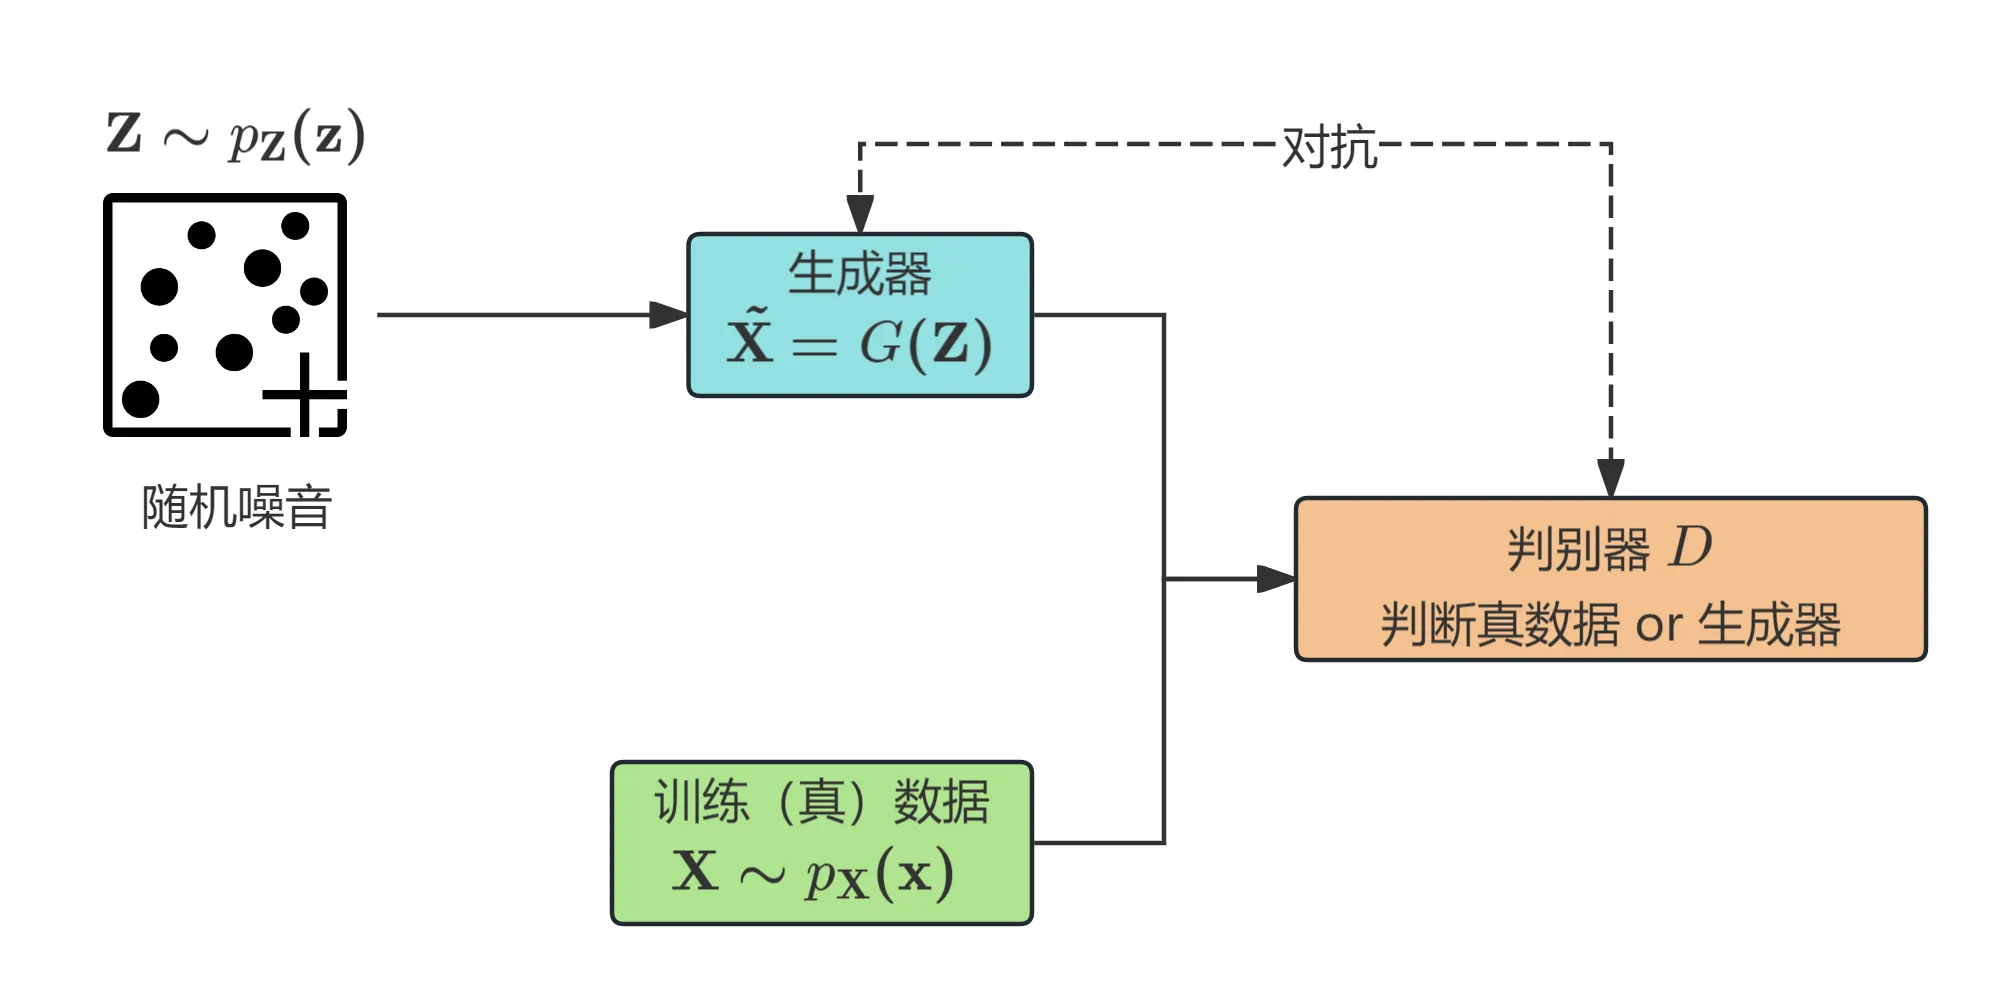
其中生成器与判别器都是神经网络,其网络结构属于超参数。
-
生成器G的任务: 输入随机噪音Z(一个向量,维度为超参),输出假图片G(Z),G(Z)的维度和真图片X一致。
-
判别器D的任务: 输入图片(真或假),输出一个0到1之间的标量,判断图片X为真图片的概率
-
GAN的优化目标公式为:
GminDmaxV(G,D)=Ex∼pX(x)[logD(x)]+Ez∼pZ(z)[log(1−D(G(z)))]
- 对于判别器D而言:如果输入的图片为真(x∼pX(x)),则要求 D(x) 越大越好;如果输入的图片为假(G(z), z∼pZ(z)),则要求 D(G(z)) 越小越好。
- 对于生成器G而言:它的目标是骗过判别器D,因此优化方向正好与D相反。
-
实际上,GAN的优化目标与交叉熵损失函数具有密切联系:
- 设判别器输入图片X~为真图片与生成图片的概率各为21,并用二元标签Y表示是否为真图片。那么判别器的输出可看作二分类概率预测P(Y=1∣X~),其对应的交叉熵损失为
H(Y,D(X~))=−E(X~,Y)[YlogD(X~)+(1−Y)log(1−D(X~))]=−P(Y=1)EX~∼pX(x)[logD(X~)]−P(Y=0)EX~∼pG(x)[log(1−D(X~))]=−21V(G,D)
-
GAN的优化算法步骤如下:
- 初始化G和D的参数θg和θd。
- 固定G,利用小批量梯度上升训练D的参数θd。尝试最大化函数
Ex∼pX(x)[logD(x)]+Ez∼pZ(z)[log(1−D(G(z)))]
- 固定D,利用小批量梯度上升训练G的参数θg。尝试最大化函数
Ez∼pZ(z)[logD(G(z))]
- 重复前两步,直到得到满意的结果。
注意上面第三步中生成器的目标函数里采用了logD(G(z))而不是log(1−D(G(z))),这是因为训练开始时,生成的图片质量肯定很差,因G(z)的取值会接近0。如果用1−logD,其在零点附近的梯度比较小,参数更新会比较慢;而logD在零点附近的梯度比较大,参数更新效率更高。
- 在实际训练中,上述前两步的具体实现如下:
- 从真实图片里随机抽取样本{x1,x2,⋯,xm}∼pX(x);
随机抽取噪音样本{z1,z2,⋯,zm}∼pZ(z);
利用当前固定的生成器G生成假图片{x~1,x~2,⋯,x~m},x~i=G(zi);
更新判别器D的参数θd:
θd←θd+η×∇θdm1i=1∑m[logD(xi)+log(1−D(x~i))]
将上述过程重复k次。
- 随机抽取噪音样本{z1,z2,⋯,zm}∼pZ(z);
更新生成器G的参数θg:
θg←θg+η×∇θgm1i=1∑mlogD(G(zi))
-
另外,GAN在训练时会让D迭代k次后再迭代G一次,其具体原因如下:
-
给定G情况下确定最优D:记X~=G(z)的分布为pG(x),则
V(G,D)=∫x[pX(x)logD(x)+pG(x)log(1−D(x))]dx
为了最大化V(G,D),我们只需要对每个给定的x,找到D=D(x)使
f(D)=pX(x)log(D)+pG(x)log(1−D)
最大。对f(D)求一阶导数:
dDdf(D)=DpX(x)−1−DpG(x)=0⇒最优的D∗(x)=pX(x)+pG(x)pX(x)
-
在给定D∗的情况下确定最优G:
V(G,D∗)=∫x[pX(x)logpX(x)+pG(x)pX(x)+pG(x)logpX(x)+pG(x)pG(x)]dx=∫xpX(x)log(pX(x)+pG(x))/2pX(x)dx+∫xpG(x)log(pX(x)+pG(x))/2pG(x)dx−2log2=KL(pX2pX+pG)+KL(pG2pX+pG)−2log2=2×JSD(pX∣∣pG)−2log2≥−2log2
等号成立当且仅当pX=pG,即生成数据的分布恰好等于真实数据的分布。
-
关于优化顺序:因为我们最终希望生成数据分布与真实数据分布尽量接近,所以最终我们还是希望最小化目标函数,于是算法会先优化D,再优化G。
-
而在实际训练中,在一轮迭代里:
- 固定初值G=G0,找到D0∗使得V(G0,D)最大;
- 固定D0∗,以G0为初值,升级G:θG←θG−η×∇θgV(G,D0∗),得到G1;
- 固定G=G1,找到D1∗使得V(G1,D)最大;
会出现一个问题:V(G1,D1∗)不一定比V(G0,D0∗)小。不过,当G1≈G0时(只作小幅更新),D1∗≈D0∗,这样基本可以保证V(G1,D1∗)≤V(G0,D0∗)。这便是每轮迭代中D升级次数比G多的原因。
GAN的经典变体
上述V(G,D∗)计算中涉及到JS散度,而当pX和pG完全分开时:
2×JSD(pX∣∣pG)=∫x:pX(x)>0pX(x)log(pX(x)+0)/2pX(x)dx+∫x:pX(x)>0pG(x)log(0+pG(x))/2pG(x)dx=∫x:pX(x)>0pX(x)log2 dx+∫x:pX(x)>0pG(x)log2 dx=2log2
而在训练初期生成分布pG与pX往往基本没有交集,这会导致训练G时梯度倾向0,训练效率低。
-
那么将生成器目标函数改回最大化Ez∼pZ(z)[logD(G(z))]是否能解决这个问题?此时代入D∗得到
Ez∼pZ(z)[logD∗(G(z))]=Ex∼pG(x)[logpX(x)+pG(x)pX(x)]=−Ex∼pG(x)[logpX(x)pG(x)]+Ex∼pG(x)[logpX(x)+pG(x)pG(x)]=−KL(pG∥pX)+Ex∼pG(x)[1−D∗(x)]=−KL(pG∥pX)+2×JSD(pX∥pG)−2log2−Ex∼pX(x)[logD∗(x)]
后面两项与G无关,因此最大化Ez∼pZ(z)[logD(G(z))]等价于最小化
KL(pG∥pX)−2×JSD(pX∥pG)=∫pG(x)logpX(x)pG(x)dx−2×JSD(pX∥pG)
JS散度取值范围在0和log2之间,因此主要考虑KL散度。可以发现:$
- 当pX(x)→0,而pG(x)>0 时, pG(x)logpX(x)pG(x)→∞。
- 当pG(x)→0 时,pG(x)logpX(x)pG(x)→0。
由此可见,在真实分布接近0的地方,G生成的分布倾向于也为0(否则KL散度会很大);而在真实分布大于0的地方,G生成的分布就算为0也不会导致KL散度很大。也就是说,该目标函数会使得G倾向于生成一些更保守的样本,而不用管是否覆盖了所有真实分布大于0的点,从而造成模型坍塌的问题。
fGAN
2016年Sebastian Nowozin等人提出fGAN,其核心是用一般的f-散度代替JS散度。f-散度定义如下:
Df(p∥q)=∫xq(x)f(q(x)p(x))dx
其中f:R+→R是连续凸函数,且f(1)=0。这样其就满足散度的基本性质:
Df(p∥q)=f(∫xq(x)q(x)p(x)dx)=f(1)=0
等号成立当且仅当p(x)=q(x)。特别地,
- 当f(x)=xlogx时,就对应KL散度;
- 当f(x)=−(x+1)log(21+x)+xlogx时,就对应2×JS散度。
接下来我们就基于f-散度从理论上对GAN优化目标进行泛化:【涉及一些凸优化的知识】
- 首先引入Fenchel共轭概念:对于上述函数f,其Fenchel共轭函数定义为
f∗(t)=x∈dom(f)sup{xt−f(x)}
它也是凸函数,且f(x)=t∈dom(f∗)sup{xt−f∗(t)}(即f∗∗=f)。将共轭函数代入f-散度得到:
Df(p∥q)=∫xq(x)f(q(x)p(x))dx=∫xq(x)t∈dom(f∗)sup{q(x)p(x)t−f∗(t)}dx≥∫xq(x)(q(x)p(x)D(x)−f∗(D(x)))dx∀D(x)=∫xp(x)D(x)−∫xq(x)f∗(D(x))dx=Ex∼p(x)[D(x)]−Ex∼q(x)[f∗(D(x))]
于是我们就得到fGAN的泛化目标函数:
GminDmaxV(G,D)=Ex∼pX(x)[D(x)]−Ez∼pZ(z)[f∗(D(G(z)))]
对此同样先确定最优的D∗:
V(G,D)=∫x[pX(x)D(x)−pG(x)f∗(D(x))]dx=∫xpG(x)[pG(x)pX(x)D(x)−f∗(D(x))]dx
在给定x时,pG(x)pX(x)D(x)−f∗(D(x))的最大值为f(pG(x)pX(x)),此时D∗(x)=f′(pG(x)pX(x))。
因此
∫xpG(x)f(pG(x)pX(x))dx=Df(pX(x)∣∣pG(x))≥0
等号成立当且仅当pX(x)=pG(x)。
- fGAN原始论文给出了部分散度的对应的f-散度函数形式:
| 名称 |
Df(P∣Q) |
生成函数 f(u) |
| Kullback-Leibler |
∫p(x)logq(x)p(x)dx |
ulogu |
| Reverse KL |
∫q(x)logp(x)q(x)dx |
−logu |
| Pearson χ2 |
∫p(x)(q(x)−p(x))2dx |
(u−1)2 |
| Squared Hellinger |
∫(p(x)−q(x))2dx |
(u−1)2 |
| Jensen-Shannon |
21∫p(x)logp(x)+q(x)2p(x)+q(x)logp(x)+q(x)2q(x)dx |
−(u+1)log21+u+ulogu |
| GAN |
∫p(x)logp(x)+q(x)2p(x)+q(x)logp(x)+q(x)2q(x)dx−log(4) |
ulogu−(u+1)log(u+1) |
Wasserstein GAN(WGAN)
2017年Martin Arjovsky等人提出的Wasserstein GAN则通过定义一种新的分布距离来替代JS散度。
-
具体而言,其提出Wasserstein距离(对于离散分布,也称为推土机距离),其示意图如下: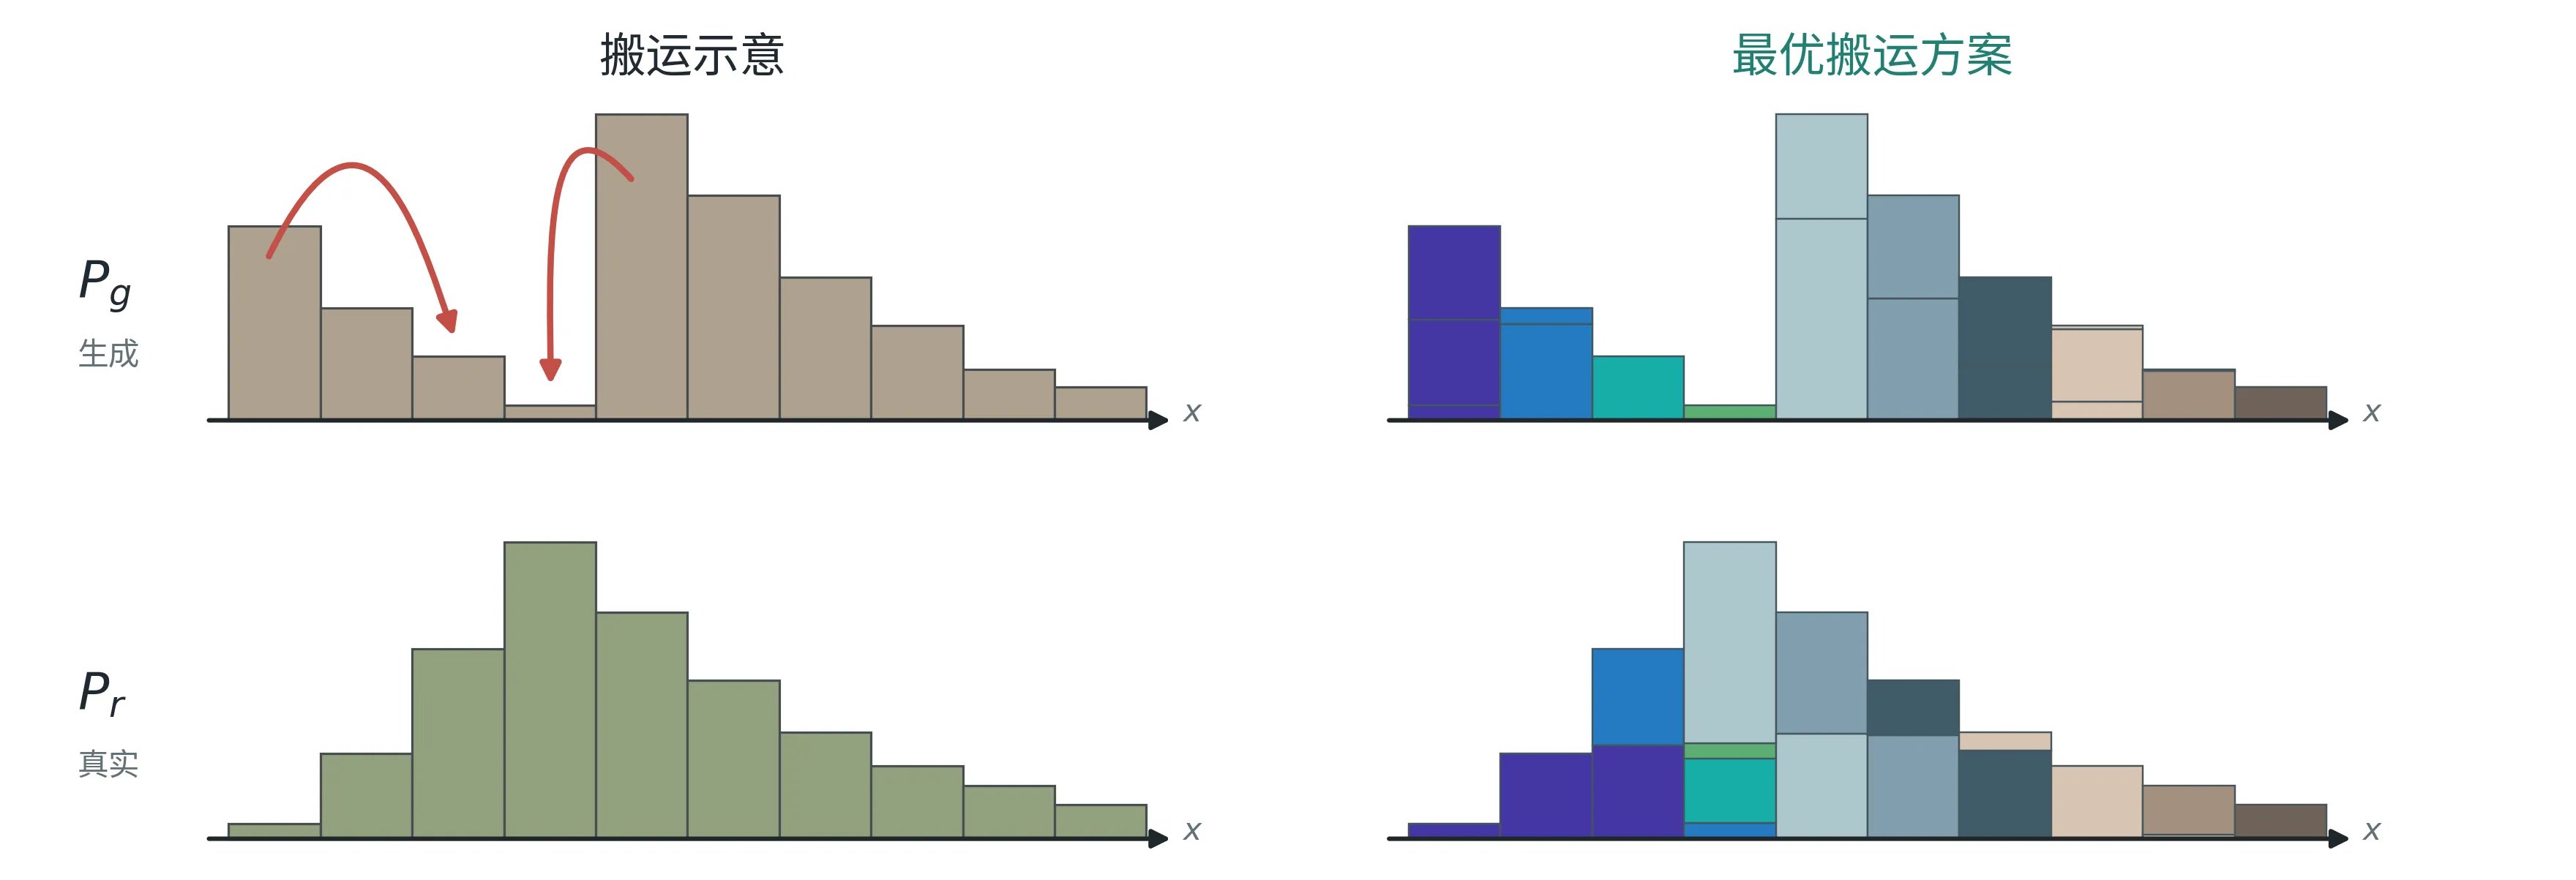
也就是说,Wasserstein距离就是让生成分布通过“移土”转换为真实分布需要的最小(距离加权)移土量。
- 那么这个最小移土量如何计算呢?实际上,可以使用一个矩阵γ表示一个移土方案,其中位置(p,q)的元素表示从位置xp向位置xq移动的土量。这样,总移土量可以表示为
B(γ)=xp,xq∑γ(xp,xq)∥xp−xq∥
而最小移土量(Wasserstein距离)则定义为
W(P,Q)=γ∈ΠminB(γ)
其中Π表示所有移土方案。
-
Wasserstein距离相比JS散度的好处在于它对分布差异更敏感,在训练初期可以更有效地引导生成分布向真实分布靠近。
-
那么在WGAN中到底是如何计算pG和pX的Wasserstein距离的呢?通过一些理论推导(主要是Kantorovich-Rubinstein 对偶定理),我们可以得到下述判别器的目标函数(G的目标函数就是基于此对G的最小化):
D∈1-Lipschitzmax{Ex∼PX[D(x)]−Ex∼PG[D(x)]}
这里的1-Lipschitz表示一阶利普希茨条件,即∥D(x1)−D(x2)∥≤∥x1−x2∥。这可以让函数更平滑,变化不那么快。
比较直观的理解:如果没有这个利普希茨条件,对上述函数的优化可能会让D在真实分布上趋向正无穷,而在生成分布上趋于负无穷,导致收敛失败。
那么这个利普希茨条件具体如何实现呢?WGAN原始论文中的方法比较直接:使用权重截断,当参数绝对值超过阈值时就收缩到阈值。
- 而随后另一篇论文(WGAN-GP)提出使用梯度惩罚实现这个条件:
Dmax{Ex∼PX[D(x)]−Ex∼PG[D(x)]−λEx∼Ppenalty[max(0,∥∇xD(x)∥−1)]}
这里的Ppenalty分布设定为PG波峰与PX波峰之间的区域(即D变化较剧烈的区域)。
当然原始WGAN-GP论文里惩罚项用的是λEx∼Ppenalty[(∥∇xD(x)∥−1)2],不过上面的Hinge惩罚相比这个平方项会让模型收敛更快,能够得到更好的最优解;另一方面,2018年又有人提出SNGAN,其效果通常比WGAN-GP更好。
DCGAN
上述变体都是对目标损失函数进行改进,而早在2015年,Alec Radford等人提出的DCGAN给出了另一个改进方向:优化G和D的网络结构。具体而言,DCGAN中生成器和判别器都使用卷积神经网络,而生成器G使用一种称为“分数阶卷积”(也称为反卷积或转置卷积)层代替池化层。下面详细解释反卷积层的原理:
- 在常规卷积中,输出尺寸i与输入尺寸o间的转换公式为:o=si+2p−k+1(p为填充,k为卷积核大小,s为步长),而反卷积就是将i与o进行调换:o=s(i−1)−2p+k
- 下面我们用矩阵对卷积进行表示:设输入与卷积核矩阵如下
input=x1x5x9x13x2x6x10x14x3x7x11x15x4x8x12x16kernel=w0,0w1,0w2,0w0,1w1,1w2,1w0,2w1,2w2,2
那么输出就是一个2×2矩阵。现在将输入与输出矩阵展平为向量:
X=inputY=output=[x1x2x3x4x5x6x7x8x9x10x11x12x13x14x15x16]⊤=[y1y2y3y4]⊤
这样输出向量与输入向量的关系可以用Y=CX表示,其中
C=w0,0000w0,1w0,000w0,2w0,1000w0,200w1,00w0,00w1,1w1,0w0,1w0,0w1,2w1,1w0,2w0,10w1,20w0,2w2,00w1,00w2,1w2,0w1,1w1,0w2,2w2,1w1,2w1,10w2,20w1,200w2,0000w2,1w2,000w2,2w2,1000w2,2
而反卷积的关系就可以用X=C⊤Y表示。
- 当然,反卷积还可以直接通过常规卷积表示:将输出矩阵进行填充,并将卷积核矩阵中心旋转得到
input=00000000000000y1y30000y2y400000000000000kernel=w2,2w1,2w0,2w2,1w1,1w0,1w2,0w1,0w0,0
这样再进行卷积就得到反卷积的结果。
- DCGAN里生成器的实际架构图如下:
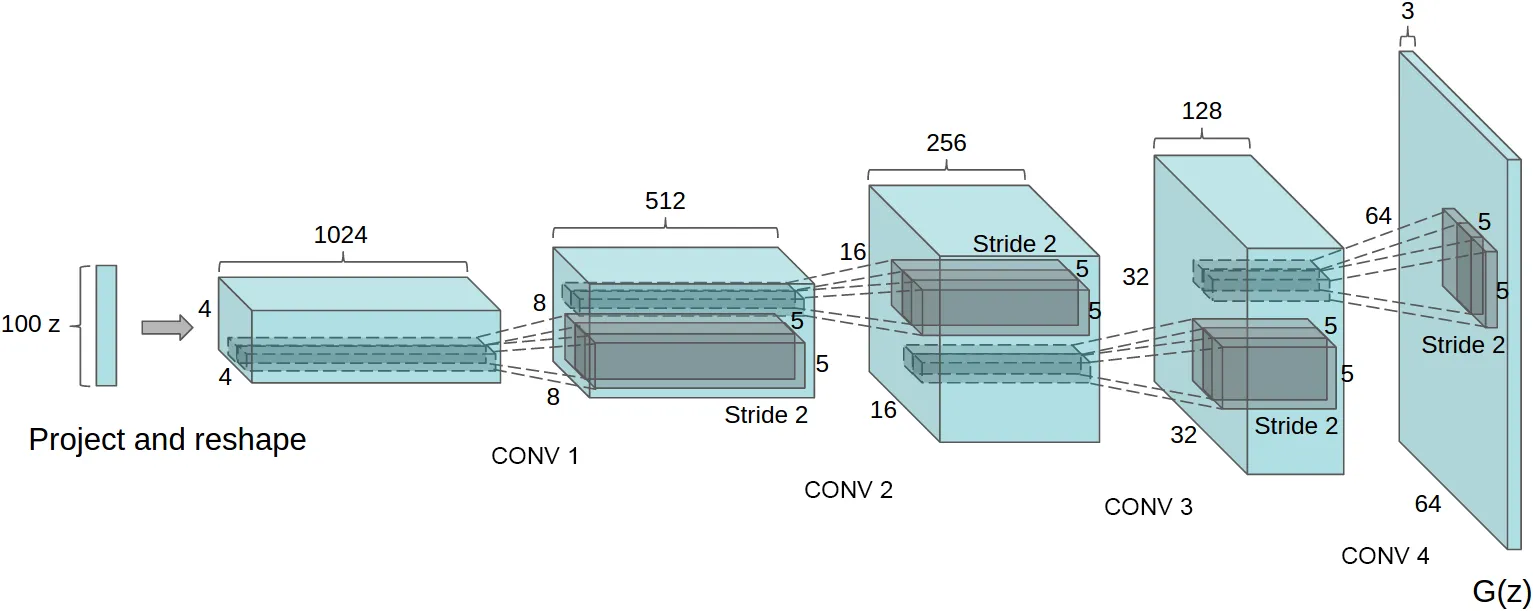
每一层参数分别为:
- CONV1:i=4,o=8,k=5,s=2,p=2
- CONV2:i=8,o=16,k=5,s=2,p=2
- CONV3:i=16,o=32,k=5,s=2,p=2
- CONV4:i=32,o=64,k=5,s=2,p=2
Cycle GAN
上面我们提到的GAN及其变体都主要用于生成与指定目标近似的数据(如图片),这本质可看作一种监督学习。那么GAN是否能够用于无监督学习任务,比如图像风格转换呢?2017年朱俊彦等人提出的Cycle GAN就解决了这个问题。
- 对于图像风格转换任务,如果直接沿用GAN结构,让替换生成器输入为原始图片样本,而目标风格图片集合作为真实样本,那么训练后生成器往往无法保留原始图片的信息。
- Cycle GAN提出的方案可以用论文的这张图表示:
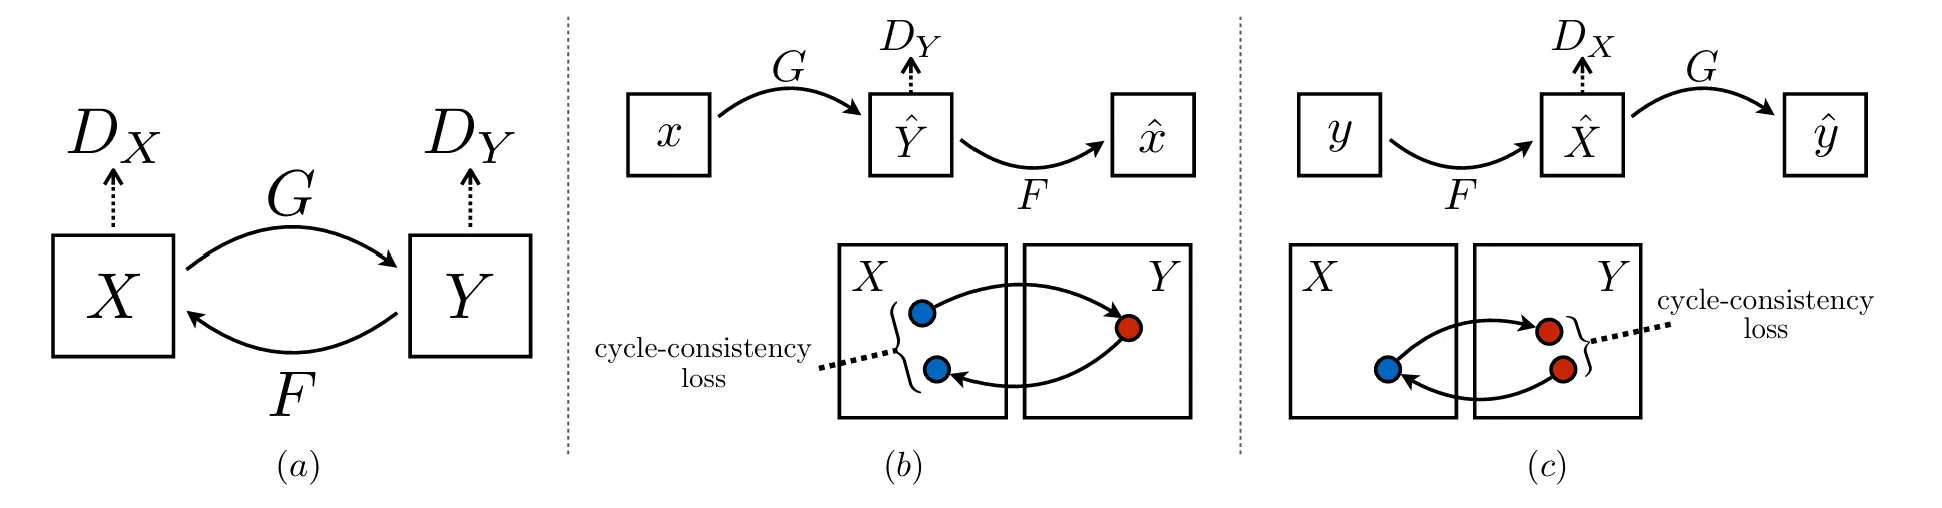
具体而言,就是在原有GAN的基础上再加入一个生成器,负责将生成的图片转换为原始风格图片。这样训练目标就是让两次生成后的图片与原始图片尽量接近(即图中的cycle-consistency)。
- Cycle GAN训练的优化目标函数如下:
GX→Y,GY→XminDX,DYmax{LGAN(GX→Y,DY,X,Y)+LGAN(GY→X,DX,X,Y)+λLcyc(GX→Y,GY→X)}
其中
LGAN(GX→Y,DY,X,Y)LGAN(GY→X,DX,X,Y)Lcyc(GX→Y,GY→X)=Ey∼pY(y)[logDY(y)]+Ex∼pX(x)[log(1−DY(GX→Y(x)))]=Ex∼pX(x)[logDX(x)]+Ey∼pY(y)[log(1−DX(GY→X(y)))]=Ex∼pX(x)[∥GY→X(GX→Y(x))−x∥1]+Ey∼pY(y)[∥GX→Y(GY→X(y))−y∥1]
条件GAN(CGAN)
那么GAN能否用于生成指定内容的图片呢(如Text-to-image任务)?2014年(在GAN提出仅仅5个月后)Mehdi Mirza等提出的CGAN就实现了这一点。具体而言,
- CGAN在GAN的生成器与判别器输入上分别加上条件(生成目标文字)数据c,同时获取真实的文字-图片配对数据样本。
- 生成的图片x=G(c,z)与真实的文字-图片对送入判别器时,判别器会同时判断生成图片与真实图片是否有明显差异,以及生成图片和输入标签是否对应。只有真实且匹配的图片判别器才应该打高分。
- 判别器训练的目标函数可以表示为
V~=m1i=1∑mlogD(ci,xi)+m1i=1∑mlog(1−D(ci,x~i))+m1i=1∑mlog(1−D(ci,x^i))
相应地,生成器训练目标函数则可表示为
V~=m1i=1∑mlog(D(G(ci,zi)))
SGAN与Triple GAN
- 当然,CGAN需要大量有标注的图像数据,这在现实中成本较高。因此在现实中往往是采用半监督学习的方法,即只有一部分图像数据有标注。这便是SGAN(2016年由Augustus Odena提出),其损失函数为
L=Lsupervised+Lunsupervised=−Ex,y∼pdata(x,y)logpmodel(y∣x,y<K+1)−{Ex∼pdata(x)logD(x)+Ez∼noiselog(1−D(G(z)))}
其中D(x)=1−pmodel(y=K+1∣x)。
- 上述原始SGAN结构实际上无法进行条件生成(它主要用于图像多分类任务),李崇轩等人与2017提出的Triple GAN就解决了这一问题。其具体架构如下:
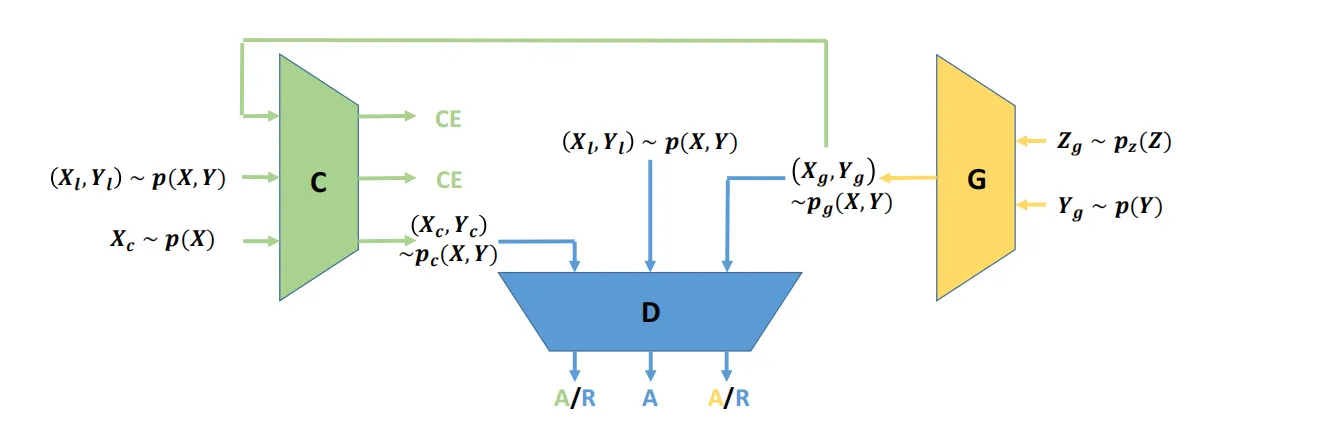
其中(Xl,YL)∼p(X,Y)表示标注数据(数据与label均为真),XC∼p(X)表示无标注数据,pc(X,Y)表示真图片、假label的分布,pg(X,Y)则表示图片与label均为假的分布。
- 可以看到,相比GAN,Triple GAN引入了一个新的对抗方:分类器C,它的目标是基于图片X尽量预测出准确的标签,让判别器D无法区分。【这与生成器G基于类别生成图片形成对照】
- Triple GAN的训练目标函数如下:
C,GminDmaxU(C,G,D)=E(x,y)∼p(x,y)[logD(x,y)]+αE(x,y)∼pc(x,y)[log(1−D(x,y))]+(1−α)E(x,y)∼pg(x,y)[log(1−D(G(y,z),y))]
简单解释:第一项是让判别器把真实数据判为真,第二项是判别器要对带假label的真图片判为假,第三项是对生成器构造的假label假图片判为假。
- 对于上述目标函数,在给定C和G的条件下,可以考虑将pc和pG合并为一个混合分布pα≜(1−α)pg+αpc,那么目标函数可以转化为
U(C,G,D)=∬p(x,y)logD(x,y)dydx+(1−α)∬p(y)pz(z)log(1−D(G(z,y),y))dydz+α∬p(x)pc(y∣x)log(1−D(x,y))dydx=∬p(x,y)logD(x,y)dydx+∬pα(x,y)log(1−D(x,y))dydx
这与GAN的形式类似,于是得到DC,G∗(x,y)=p(x,y)+pα(x,y)p(x,y)。将其代回U(C,G,D)会发现只剩下p(x,y)和pα(x,y)间的散度,因此无法保证pc(x,y)=pg(x,y)。
- 为解决这一问题,考虑在目标函数上增加一项RL=E(x,y)∼p(x,y)[−logpc(y∣x)]。可以证明,最小化RL等价于最小化KL(p(x,y)∥pc(x,y)),且RL与D无关,所以这样就能让最优解满足p(x,y)=pc(x,y)=pg(x,y)。
- 当然,在实际的Triple GAN训练中,还会另外增加一项αPRP=αPEpg[−logpc(y∣x)],这可以防止生成器G出现模型坍塌。
变分自编码器(VAE)
生成模型的另一个方向是先将数据编码为潜空间分布(作为近似后验),再从先验分布采样,经过解码器生成数据。这一思想可以最早追溯到1986年Hinton团队提出的反向传播论文,在2006年通过Deep AE基本确定架构,最终到2013~14年由Kingma与Welling提出变分自编码器VAE,在深度生成模型里占据一席之地。
- 自编码器的本质是一种自监督学习方法,通过一个编码器和一个解码器(通常为神经网络),将数据转化为向量(一般为低维),再从向量重建数据。【这里的向量也可看作数据的嵌入或表示】
- VAE在自编码器的基础上还吸收了EM算法与变分推断的思想。关于EM算法和变分推断的基本概念可以参见机器学习方法 Ch.15 概率模型估计方法,这里不再赘述。
- VAE的基本架构图如下(图源蒲公英书):
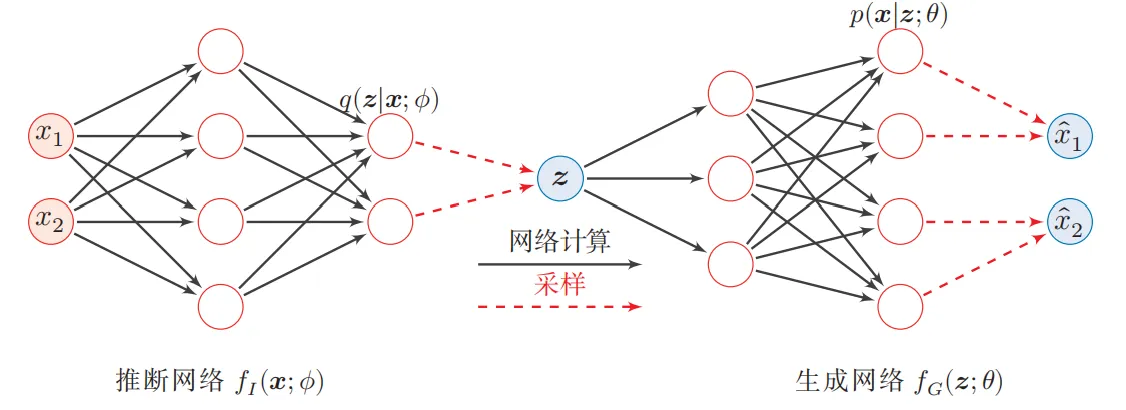
其中编码器用于估计变分分布q(z∣x;ϕ),解码器则基于变分分布中采样的z估计条件分布p(x∣z;θ)。
- 推断网络(编码器)的目标函数为:
ϕ∗=ϕargminKL(q(z∣x;ϕ)∣∣p(z∣x;θ))=ϕargmaxL(q,x;θ,ϕ)
推导提示:
logp(x)L(q,x;θ,ϕ)=L(q,x;θ,ϕ)+KL(q(z∣x;ϕ)∣∣p(z∣x;θ))=Ez∼q(z∣x;ϕ)[logq(z∣x;ϕ)p(x,z;θ)]
- 同理,生成网络(解码器)的目标(极大似然估计):
θ∗=θargmaxEz∼q(z∣x;ϕ)[logp(x,z;θ)]=θargmaxL(q,x;θ,ϕ)
实际上,上述优化编码器与解码器的过程恰好对应EM算法的E步与M步。由此可得VAE的总目标函数为
θ,ϕmaxL(q,x;θ,ϕ)=θ,ϕmaxEz∼q(z∣x;ϕ)[logq(z∣x;ϕ)p(x∣z;θ)p(z)]=θ,ϕmaxEz∼q(z∣x;ϕ)[logp(x∣z;θ)]−KL(q(z∣x;ϕ)∣∣p(z))
- 注意到上述目标函数里涉及到对z的随机采样,这导致解码器梯度难以反向传播到编码器。对此,VAE的解决方案是进行重参数化:
- 令z=μz+σz⊙ϵ,ϵ∼N(0,I),这样z∼q(z∣x;ϕ)=N(μz,diag(σz2)),其中[μzσz2]=fI(x,ϕ) 由推断网络(编码器)来进行建模。
- 另外假设先验分布p(z)=N(0,I),这样我们就能将KL散度重新写为
−KL(q(z∣x;ϕ)∣∣p(z))=−KL(N(μz,diag(σz2))∣∣N(0,I))=21j=1∑J(1+logσzj2−μzj2−σzj2)
其中J为z的维度,μzj和σzj2分别为μz和σz2的第j个分量。
- 最终我们得到VAE的训练过程:
-
从N(0,I)中随机抽出样本ϵ1,ϵ2,⋯,ϵM
-
计算zm=μz+σz⊙ϵm
-
计算Ez∼q(z∣x;ϕ)[logp(x∣z;θ)]≈M1m=1∑Mlogp(x∣zm;θ)
-
目标函数近似表达为
M1m=1∑Mlogp(x∣zm;θ)+21j=1∑J(1+logσzj2−μzj2−σzj2)
其中[μzσz2]=fI(x,ϕ)来自于编码器,p(x∣zm;θ)为解码器。
-
给定样本x1,x2,⋯,xn,利用随机梯度上升来求解。
- 最后总结下VAE的特点:
- 将潜在变量的条件强制为单位范数,压缩形式是潜在变量的均值和方差;
- 潜在变量是平滑连续的,且其随机值在解码器产生有意义的输出;
- 解码器的输入是从具有编码器输出均值和方差的高斯中采样的随机值;
- 正则化的潜在空间,具有生成能力。
扩散模型
在介绍扩散模型前,先引入前向和反向扩散过程:
- 前向扩散过程可以理解为:从一张图片开始,逐步加入随机噪音,最终得到纯高斯噪音图片。其数学形式为:
q(xt∣xt−1)=N(xt;αtxt−1,(1−αt)I)
由此可以推导出xt∣x0的分布:
xt∣x0∼N(αˉtx0,(1−αˉt)I)
其中αˉt=α1α2⋯αt。由此可知,当t→∞时,xt∣x0⟶dN(0,I)。
- 反向扩散过程则恰好与前向扩散过程相反,相当于从噪音图片逐渐还原出图像。由上述公式可以推出:
q(xt−1∣xt,x0)=q(xt∣x0)q(xt∣xt−1,x0)q(xt−1∣x0)=N(xt;αˉtx0,(1−αˉt)I)N(xt;αtxt−1,(1−αt)I)N(xt−1;αˉt−1x0,(1−αˉt−1)I)∝exp{−21[1−αt(xt−αtxt−1)2+1−αˉt−1(xt−1−αˉt−1x0)2]}=exp{−21[(1−αtαt+1−αˉt−11)xt−12−2(1−αtαtxt+1−αˉt−1αˉt−1x0)xt−1]}∝Nxt−1;μq(xt,x0)1−αˉtαt(1−αˉt−1)xt+αˉt−1(1−αt)x0,Σq(t)1−αˉt(1−αt)(1−αˉt−1)I
- 然而,直接的反向扩散过程不能用来生成图片,因为缺乏原始图像数据的支持。一个合适的训练方案是通过训练另一个概率分布p(xt−1∣xt),使其接近q(xt−1∣xt,x0)。也就是说要使得
p(xt−1∣xt)∝Nxt−1;μθ(xt,t)1−αˉtαt(1−αˉt−1)xt+αˉt−1(1−αt)x^θ(xt,t),Σq(t)1−αˉt(1−αt)(1−αˉt−1)I
其中x^θ(xt,t)为待训练神经网络,θ为参数。其训练损失函数即为KL散度:
DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))
具体展开计算如下:
DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))=DKL(N(xt−1;μq,Σq(t))∥N(xt−1;μθ,Σq(t)))=21[log∣Σq(t)∣∣Σq(t)∣−d+tr(Σq(t)−1Σq(t))+(μθ−μq)⊤Σq(t)−1(μθ−μq)]=21[(μθ−μq)⊤(σq2(t)I)−1(μθ−μq)]=2σq2(t)1[∥μθ−μq∥22]=2σq2(t)1(1−αˉt)2αˉt−1(1−αt)2[∥x^θ(xt,t)−x0∥22]
其中σq2(t)=1−αˉt(1−αt)(1−αˉt−1)。
- 上述目标函数仍然难以训练,且预测μθ的效果不稳定。因此下述训练的等价形式被推出:
- 首先,前向扩散过程里x0可以直接由xt得到:
xt=αˉtx0+1−αˉtϵ⟹x0=αˉtxt−1−αˉtϵ
将其代回μq(xt,x0)中,得到
μq(xt,x0)=1−αˉtαt(1−αˉt−1)xt+αˉt−1(1−αt)x0=αt1xt−1−αˉtαt1−αtϵ
由此可见其只和xt与ϵ有关。
- 于是我们可以直接训练噪声神经网络:
μθ(xt,t)=αt1xt−1−αˉtαt1−αtϵ^θ(xt,t)
将其代入KL散度得到
DKL(q∥pθ)∝2σq2(t)1∥μθ−μq∥22=2σq2(t)1(1−αˉt)αt(1−αt)2∥ϵ−ϵ^θ(xt,t)∥22
这便是扩散模型“预测噪声”的精髓。
当然,扩散模型的算法远不止于此,实际模型常常会考虑连续时间状态情形,此时需要用到随机微积分的知识,这里就不详细展开了。